速览
特别策划
2026-09-14 18:03今年 9 月,一批金色的 Cybercab 开始在美国得州奥斯汀街头提供付费服务。
相比于汽车行业,这件事对机器人行业的意义更大:一个由 AI 感知、决策并作用于现实世界的机器,开始执行可以直接计价的商业任务。
这恰好印证了 Andrej Karpathy 在特斯拉负责 AI 时说的一句话:汽车本来就是机器人,Tesla 本质上是一家“robotics at scale”的公司。
过去,人们习惯用外形来理解机器人:双足、人形、机械臂。而一旦以外形来定义机器人,人们对它商业场景的想象也很容易随之变窄。
当 AI 开始接管感知、决策和控制之后,仅凭外形,已经很难判断一台机器的真实商业价值。让它完成任务的,是它体内那套能感知、会决策、并驱动身体完成任务的智能系统。行业里更愿意把它叫作“大脑”。
当同一套“大脑”可以持续控制成千上万台机器,在真实场景中完成任务、积累数据,并让第三方基于它部署业务,公司出售的就不再只是某种硬件,而开始接近一种物理世界的智能基础设施。
行业其实已经演示过一遍这种公司长什么样——操作系统、云、大语言模型的 API,都是“一次投入、多方复用”的结构。
由此,一个比“谁能造出最好的机器人”更重要的问题浮出水面:到底什么样的公司,最终有机会成为具身智能的平台型企业?
2026 年的中国是回答这个问题的合适地点。随着宇树等具身智能厂商相继启动或完成上市,这条赛道正式交由二级市场定价。身处其中的玩家,在资本的聚光灯下,因生态位的差异,各自走到了截然不同的十字路口。
9 月 11 日,启动独立融资后的蚂蚁灵波 CEO 朱兴首次公开露面,把这个问题的一部分答案推向台前;答案的另一部分,则散落在外滩大会的展区、合作伙伴和真实场景之中。
把台上台下的这些碎片拼在一起,一条平台化的路径正在逐渐变得清晰:蚂蚁灵波想做的,并不是再造一台属于自己的机器人,而是成为更多广义机器人背后的那颗“通用大脑”。
站在具身智能十字路口,该向哪侧看?
当具身智能从技术演示走向商业部署,不同生态位的公司,正在望向不同的“北极星”。
独立具身大脑公司追求的是复用率。Skild AI、Physical Intelligence、Generalist AI、FieldAI都在尝试让一套智能跨机器人、跨任务反复使用。今年 1 月,Skild AI 完成 14 亿美元新一轮融资,估值超过 140 亿美元;Physical Intelligence 在 2026 年5 月最新一轮融资约10.5 亿美元,估值约 112 亿美元。资本已经愿意为独立于整机的智能能力定价。
具身本体公司看到的是出货量。Figure、1X、宇树首先要解决制造、成本和供应链,但也在加速补“大脑”——Figure 在 2025 年结束与 OpenAI 的合作后自研了 Helix;宇树招股书显示,其 IPO 募资 42.02 亿元中,约 48% 投向了模型研发。
第三类玩家是场景方,他们不关心模型是谁的,只核算部署成本、工作量替代、故障率和回本周期,北极星是单点 ROI。
三股力量之间存在真实的张力,平台机会就诞生于此。真实场景里,机械臂、移动底盘、人形机器人往往同时存在,场景方希望一套智能能跨硬件迁移、持续降低部署成本;本体公司面对一个经典的“自建还是采购”问题,具身基础模型的预训练投入巨大,每家本体厂都自己付一遍,整个产业的效率会很低;而对具身基础模型来说,接入的机器人越多,软件边际成本越低,回流的物理数据又反过来抬高泛化能力。
把智能从单一本体里抽离出来、成为跨硬件复用的基础层——这就是独立“大脑公司”的位置。它成立的前提是一个可以被验证的经济学命题:随着接入的本体和场景增加,把模型适配到下一台机器、下一个场景的边际成本必须持续下降。 做不到这一点,“大脑公司”就只是一家项目制的算法外包商。
那么,什么决定这个边际成本下降?沿着全球头部公司的路线,有五个杠杆:
第一,大规模自主预训练。这决定了能力的起点。
第二,数据管线与 Infra。回流的数据能否真正变成模型能力,而不是堆在硬盘里。
第三,跨构型的模型设计。决定同一套模型能覆盖多宽的硬件形态。
第四,全栈的工具链。决定合作伙伴用起来的门槛有多低。
第五,外部采用。前四项是否成立,最终要用第三方愿不愿意把自己的机器人交给这套模型来检验。
这五项能力并不是并列的:大规模自主预训练是核心;数据管线与 Infra 是根;跨构型决定能力能否复用;工具链决定复用的门槛;外部采用是市场的判决。
沿着这五把尺子看中国市场,候选者不少,但同时在预训练、数据体系、模型设计和工具链上持续投入,并已进入外部本体和真实商业场景的公司并不多,蚂蚁灵波无疑是解析价值最高的样本之一。
长线者手里的筹码
要拆解蚂蚁灵波,方式或许有一万种。过去一年,这家公司在数据、模型、架构和场景上铺开的东西已经足够多。相比逐项罗列技术名词,从一次真实的产业选择切进去,可能更容易看清这些能力之间的关系。
这个选择来自乐聚,开发 KUAVO-VLA 时,乐聚最终选择 LingBot-VLA 2.0 作为通用基座。乐聚从机器人本体和小脑控制起家,随后延伸到数据和垂域模型,本身具备模型研发能力——这让它的选择更值得追问。
乐聚机器人联合创始人兼 CEO 常琳在外滩大会上提到,双方团队“融合程度非常高”;蚂蚁灵波 CEO朱兴则形容,灵波把基模和工具链交给乐聚,同时也持续吸收乐聚在本体和场景侧的输入。
一家已经拥有本体、数据和算法能力的机器人公司,为什么仍然选择建立在LingBot这个基座上?
答案的第一层,是大规模预训练的门槛。蚂蚁灵波科技首席科学家沈宇军在外滩大会上专门提到,从零到一开发基模,与基于已有模型继续微调,需要的是两套不同的能力——难点不只在模型结构,还包括能否把大规模数据稳定运行在大规模算力上,并持续产出可迭代的模型。
朱兴也多次把预训练看作基座公司的重要分水岭。回看大语言模型的发展,最终留在“主桌”上的玩家,都经历了从零预训练的高投入和高风险;在别人模型上做微调的公司,很少能形成独立的议价权。具身智能进入“百模大战”后,类似的分化也正在出现。
蚂蚁灵波联合国大药房打造的智慧药房,已在国大药房上海门店投入运营
灵波目前押注的,是持续训练和迭代通用基座的能力。对乐聚这样的厂商而言,采用基座与自主研发也并不矛盾——不必把整套预训练体系从头再建一遍,仍然可以围绕自己的本体和场景,发展专有的模型能力。
第二层是数据。LingBot-VLA 2.0 用了 6 万小时预训练数据,但这个数字本身不是重点。对具身基模来说,预训练的难点从来不只是把数据规模做大,还包括如何组织数据分布、判断哪些数据真正有效,以及让模型持续从真实世界的反馈中修正训练方向。
原因在于,物理世界里的 OOD (分布外泛化)几乎是常态:光照、背景、物体和任务持续变化,本体本身还存在硬件误差和运动误差。蚂蚁灵波科技首席数据科学家黄用韬在 WRC 2026 上表示,单纯把 10 万小时扩到 100 万甚至 1000 万小时,也不会自然解决泛化问题。
问题也因此逐渐从“有多少数据”,转向“模型究竟需要什么数据”。这要求模型公司掌握更深的数据 know-how:哪些场景和任务值得采集,什么轨迹有效,哪些数据应该过滤,模型失败之后又应该补充哪一类数据。
这也是为什么蚂蚁灵波很早便从采购成品数据转向定制化采集。大规模用工和场景运营可以交给专业供应商,模型公司则重点掌握数据标准、采集 SOP、质量判断、数据配方,以及模型向采集端回传需求的能力。黄用韬把这套思路概括为“Feedback is all you need”。
蚂蚁灵波已经搭出一套持续把物理数据转化为模型能力的 Infra。朱兴透露,原始数据进入模型训练的数据漏斗可用率,也从早期约 15%提升到 90%以上。
对一个基座公司来说,这个数字比 6 万小时更加重要。它意味着每一小时新采回来的数据,有多少能真正变成模型能力,这直接决定下一个场景的数据成本能不能降。
第三层是模型设计的原则。 沈宇军复盘过去一年时提到,行业早期存在一定的数字世界路径依赖:VLA 借助 VLM,WAM 借助视频生成,希望沿用已经成熟的数字模型能力。但机器人面对的是持续输入的传感器信号、视觉、空间和力等物理模态,以及最终必须实时执行的动作。
灵波把自己的研发原则称为“具身原生”:从机器人在物理世界工作的要求出发,来设计数据、训练目标和模型。距离估计是否准确,动作能否及时响应,换一种身体还能否完成任务,这些要求都需要在预训练阶段得到处理。
搭载蚂蚁灵波通用大脑的钛虎机器人完成工业上下料
机器人并没有统一的“身体”。单臂、双臂、灵巧手、腰、头和移动底盘,在自由度和动作空间上都存在差异。LingBot-VLA 2.0 从预训练阶段便引入多构型数据,并通过统一动作空间、动作侧 MoE 等设计,尝试让不同身体共享更多控制能力。对于希望承担平台角色的大脑公司而言,这一点无法绕开。工业中的重载、分拣,以及未来家庭中的服务机器人,都可能采用完全不同的硬件形态。如果模型长期绑定单一本体,其复用范围自然会受到限制。
灵波的全栈模型投入也有类似的考虑。空间感知不准,会影响抓取;无法预判环境的变化,动作规划也会受限。Vision、Depth、VLA、World、VA、Zero-WAM 看上去属于不同方向,但它们共享数据、训练 Infra 和物理世界的研究经验,并始终围绕同一个核心问题展开:如何让机器人更好地理解物理世界,并最终完成行动。
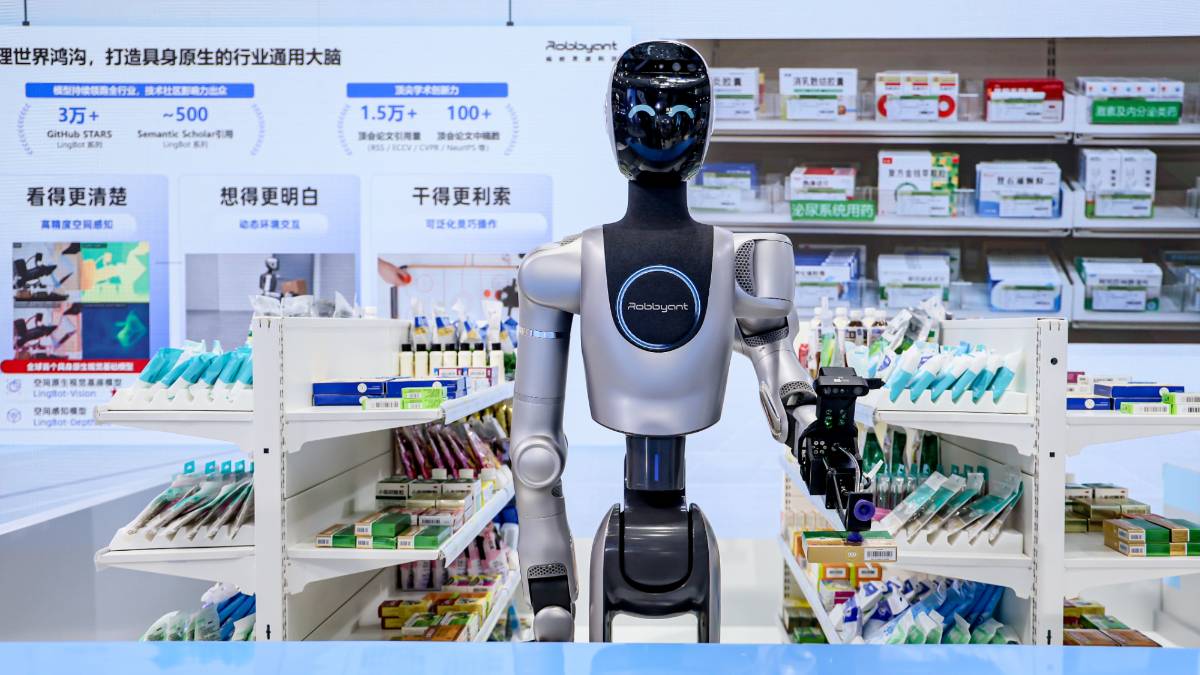
搭载蚂蚁灵波通用大脑的乐聚机器人在零售药房工作
朱兴透露,灵波早期的 VA 曾基于通用视频生成模型继续训练,但随着研发深入逐渐碰到上限,随后开始转向大规模自主预训练,并在空间感知、环境预测和可泛化灵巧操作上,都发布了面向具身智能的预训练基模。
当然,平台能力最终仍然需要体系之外的验证。LingBot-VLA 2.0 在 GM-100 双臂平台上已经进入通用 VLA 的第一梯队,而乐聚提供了一个更具体的产业样本。
据乐聚披露,在 LingBot-VLA 2.0 完成 KUAVO 基础迁移后,乐聚加入 600 多小时真机数据二次训练,成功率从 16.27%提升至 48.27%,过程分从 42.06%提升至 74.51%;新技能仅需约 5 小时示范数据便可达到约 80%的成功率,整体训练成本下降超过一半。
这些数字至少说明了一种可能的分工方式:通用基座先提供更高的能力起点,本体厂再利用自己的数据、场景和工程能力完成垂域适配。
沈宇军也给出过更产业化的评价标准:下一代基模发布后,合作伙伴完成同一个场景所需要的数据、时间和落地成本,能否继续下降。相比单纯看 benchmark,这可能更接近平台型基模在产业中的实际价值。
到这里,乐聚为什么选择 LingBot,也就有了一个相对清晰的解释:它可以把投入最重、周期最长的通用预训练交给基座,同时把更多资源集中在本体、客户和垂域能力上。
而当镜头继续拉远,奥比中光、Reactor、国大药房又分别从传感器、开发者和终端场景接入,围绕 LingBot 的合作开始延伸到产业链的不同环节。
至此,已经能看到灵波几张逐渐成形的牌:作为底座的数据管线与 Infra,作为核心的大规模预训练,作为设计原则的具身原生,以及作为最终检验的外部采用。
近期的独立融资,正开始把这套平台化路线推向新的阶段。
融资摊开,路线图浮出水面
前面的几张牌,回答了蚂蚁灵波已经积累了什么。独立融资之后,更值得观察的,是这些能力接下来如何被放大。
在 CEO 沟通会上,朱兴专门回应了融资动机:一是核心 AI 人才的市场化激励,二是公司治理。具身智能需要长期投入、穿越多个产业周期,更独立的治理结构,也让灵波拥有了更清晰的公司边界。
这条边界进一步明确了它在产业链中的位置。朱兴表示,灵波会继续聚焦智能中心和通用大脑,对外核心输出基座模型和工具链——覆盖后训练、数据处理、端侧部署、真机强化学习等环节,再由本体厂和解决方案商结合具体机器人与客户场景完成适配。乐聚已经呈现出这套分工的雏形。数据服务商、传感器厂商、芯片厂商和场景客户则从不同环节加入。
内部保留的 R 系列机器人,定位不是与本体厂竞争,主要服务模型研发和生活服务等前沿场景探索——朱兴把它定义为“2B2C”的前哨:在机器人进入家庭之前,先在与人有接触的生活服务场所,完成技术和商业的早期验证。
朱兴对商业化也保持着一定克制。过早投入大量定制项目容易消耗基座研发资源,真实付费客户和商业场景又不可缺少,它们能够把模型放进更严格的环境中,让异常和失败重新回到训练体系。
商业化由此成为模型迭代的一部分。基模进入更多本体,经过后训练走向真实场景,再让场景中的反馈回到模型。如果这套循环逐渐扩大,灵波连接的将是一张由本体、数据和场景共同构成的反馈网络。
朱兴给明年定了两个可检验的指标:模型驱动的机器人真实干活的数量,以及相同场景任务下后训练数据成本的“指数级下降”。这两个指标能不能兑现,是这套平台叙事下一次接受检验的时间点。
结语
日本传统纸牌游戏花札里,有一种玩法叫 Koi-Koi。
当手里的牌凑成一副有效牌型,玩家可以就此结束这一局、落袋为安,也可以喊一句“Koi-Koi”——继续摸牌,去争取一个更大的组合。
某种程度上,今天的蚂蚁灵波正站在同一个位置上。沿着五个杠杆看,它的牌相对齐全:大规模自主预训练,一套可用率从 15% 走到 90% 的数据管线,从预训练阶段就面向多构型的模型设计,正在铺开的工具链,以及从乐聚、国大药房开始的外部采用。
更重要的是,这些牌正在开始彼此组合。独立融资,又把它推向了一张更大的牌桌。
如果把具身智能看作一场刚刚开始的长牌局,此刻的蚂蚁灵波显然刚开始出牌。
它没有停下计分,而是喊了一句“Koi-Koi”。
而平台型公司的想象力,正在于这些尚未完成的组合:接入的身体越多,进入的场景越广,沉淀的数据越丰富,基础模型也就越有机会继续向前演化,再去触及此前无法触及的身体和场景。
下一张牌的价值,未必只在它自身。它也可能让此前握在手里的每一张牌,都多出一种可能的组合。
蚂蚁灵波选择继续摸牌。
本内容未经允许不得转载。授权事宜请联系 hezuo@huxiu.com。