2026-09-14 18:20
速览
本文来自微信公众号: 凌霄-科技投资人 ,作者:凌霄
我这两天一直在看DeepSeek的两张表。一张已经摆在台面上,写着模型更强、缓存更省、价格更低;另一张还没有公开,却更值得投资人盯紧:它究竟靠什么赚钱?
9月10日,DeepSeek发布V4.1 Flash,官方称其对HBM的需求降至上一代的四分之一,对SSD的需求降至八分之一,并同步下调API价格。就在前一天,媒体报道称中信证券已与DeepSeek接洽并进入IPO尽调,但双方尚未签署正式辅导协议。
把这两条消息放在一起,味道就出来了。技术团队继续把每一次推理做得更便宜,资本市场则准备追问,这些成本优势能沉淀出多少收入和现金流。国产大模型的竞争,正在从证明“我能做出来”,走向回答“我能不能长期赚到钱”。
01
上市不是马上交利润
今年6月,上交所专门发布人工智能大模型企业适用科创板第五套上市标准的指引,支持尚未形成一定收入规模的优质企业上市。因此,“开始算账”并不等于要求DeepSeek立即盈利,更不意味着资本市场否定长期研发。
真正的变化,是一家私营技术公司一旦走向公开市场,核心技术、收入来源、研发支出和持续经营能力都要接受更透明的检验。过去一句“为了未来投入”能够解释很多问题,上市之后,投资人会继续追问这笔投入何时产生客户、复购和规模效应。
一级市场可以根据论文、榜单和开发者热度给出想象空间,二级市场更关心客户为什么付费。企业调用API是真实生产需求,还是补贴催生的流量;收入增长能否覆盖推理成本;价格下降后,毛利还能不能守住,这些问题会直接影响估值。
DeepSeek的开源路线带来了巨大的影响力,也让价值获取变得更复杂。开发者可以自行部署,云厂商也能托管同一套模型,用户多并不自动等于官方收入高。开源影响力能否变成稳定付费和客户留存,才是IPO真正要交的答卷。
02
DeepSeek的底牌仍是效率
DeepSeek最有分量的能力,始终是用架构创新压低训练和推理成本。V4.1 Flash采用非对称结构,输入阶段只激活8B参数,输出阶段激活16B参数;缓存占用继续下降,说明它的竞争力并不只来自跑分,也来自工程效率。
效率提升会带来很直接的商业机会。单次调用更便宜,企业才敢把模型塞进客服、编程和Agent流程;同样一笔算力预算,也能支撑更多请求。对一家底座模型公司来说,成本优势既能帮助扩张,也能成为面对云厂商和海外模型时的议价筹码。
但技术报告里的低成本,和财务报表里的高毛利不是同一个概念。研发试错、数据处理、峰值算力冗余、网络与存储、企业服务以及安全合规,最终都会进入损益表。模型把一次推理压到很低,不代表整家公司已经进入轻资产模式。
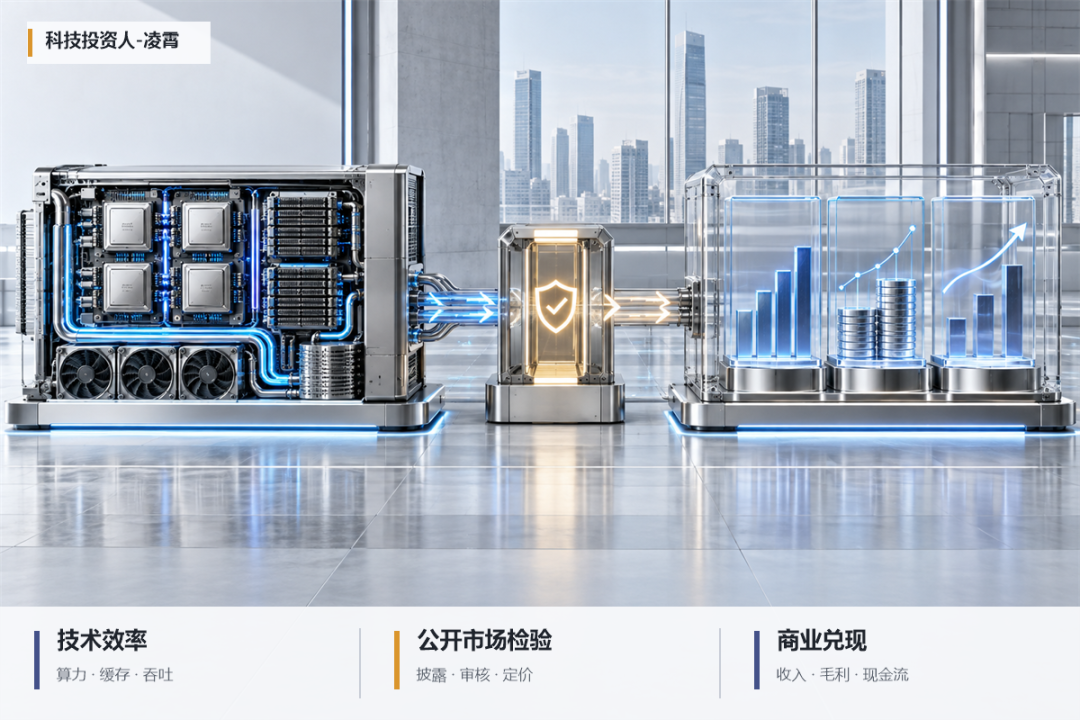
这也是DeepSeek需要解决的关键矛盾:价格越低,市场越容易做大,但每个Token留下的钱也可能越少。只有调用量、复购率和算力利用率一起改善,技术效率才会成为商业护城河。会省算力只是第一步,能把省下来的钱留在利润表里才算完成闭环。
03
行业会按算账能力分层
DeepSeek若继续推进IPO,影响不会只停留在一家公司。国内大模型的价格竞争仍会持续,但无目的的免费和补贴会越来越难解释。低价可以是获客工具,前提是客户留下之后产生的收入,能够覆盖服务成本。
算力采购也会换一套评价方式。市场不会再只为“万卡集群”鼓掌,而会看GPU利用率、单位推理成本和真实业务产出。机房里亮着多少卡并不重要,重要的是这些卡有没有变成客户愿意持续付费的服务。
资金会向两类企业集中:底座层要同时具备模型效率和商业化能力,应用层要掌握行业数据、客户入口与工作流程。夹在中间、技术没有明显差异,又缺少稳定场景的公司,会最先感受到融资和估值压力。
人才也会随之重新定价。只会训练模型还不够,能把模型、推理系统和客户需求接到同一张利润表上的人会更稀缺。我更关心的不是DeepSeek何时递交招股书,而是它未来公开的第一份财务数据,能不能证明低成本模型也是一门好生意。如果这家公司真的来到科创板,你会为它的技术效率买单吗?
本内容由作者授权发布,观点仅代表作者本人,不代表虎嗅立场。
如对本稿件有异议或投诉,请联系 tougao@huxiu.com。
如对本稿件有异议或投诉,请联系 tougao@huxiu.com。