2026-09-28 13:37

速览
本文来自微信公众号: 奶爸老徐 ,作者:奶爸老徐,原文标题:《为了去掉AI腔,我居然跟AI吵了半个月,最后Opus5.5 让我砍了它》
在我的翻译技能开源发布后,一有空就用它更新我的连载翻译。本来寻思这个流程里,AI翻一遍,审两遍,我一定很省心……
结果因为AI腔竟然跟AI撕了半个月!
最后Opus 5.5出炉,上来就说让我把它砍了。
书接上回,翻译技能发布之后,为了验证技能的效果,我还专门写了让AI写了个看板,抓取各流程的时间戳来监测《弗兰兹·洛纳编年史》的翻译效率。
本打算以后真提效了,就把图一截,放项目说明里去吹牛逼~!
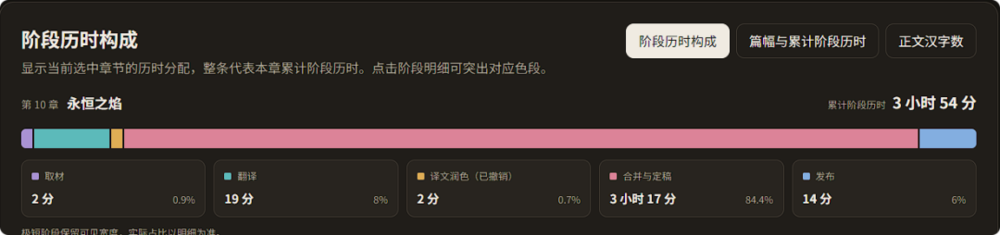
由于看板高度依赖项目的自动化脚本,所以目前没有集成进Translation Workbench技能
结果一看用时,怎么还这么久?
我一度怀疑AI的代码有问题。AI很委屈,反手掏出证据打了我的脸。
脸肿了以后我开始反思,一定是我自己哪个环节还不够高效。
然后我注意到一个现象:AI经常拿英文原文+我定下的翻译风格来反驳我。我寻思,初稿是AI翻译的,那是不是因为我对原文的情绪把握不够呢?
或者说,是我对AI翻译背后的思维链了解不够呢?
如果AI把当初翻译的时候怎么想的,为什么这么翻,哪个地方拿不准都告诉我,这样不就可以达到人机合一的境界?
可惜……畅想中的和谐场面并没有发生,反而我和AI的矛盾进一步激化。
横跨数章,历时半月的大型撕逼现场
首先,增加情绪线后,审核的时候AI对初稿的修改意见变少了。并且经常拿它写的情绪线作为依据来怼我:要么说我语序这么调整不对,要么说我翻译漏词了。
一开始我忍着,并尽可能按照AI的要求去调整措辞,这导致我前面的章节不自觉地留下更多的AI痕迹,比如不是那么必要的破折号。
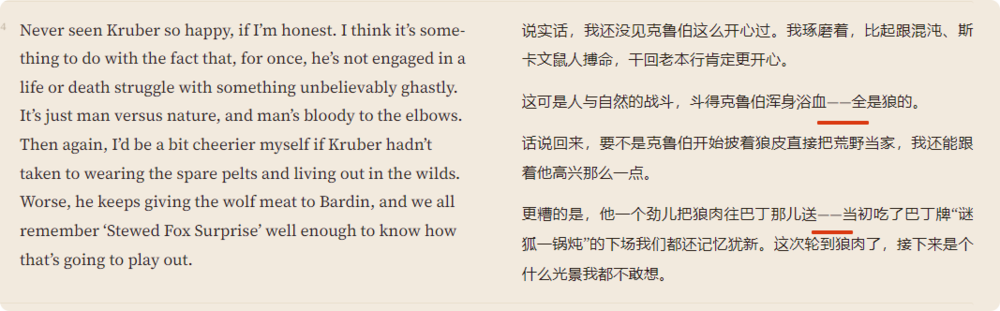
取自我的双语站截图,第七章《冬狼》
事实上等到我审核的时候,我发现AI对原文的理解多少有点过头。
可是如果我一开始就审情绪线,那就意味着AI初稿开始我就要去理解全文,那我还要AI审个der啊?
不行!
我又生一计:审核步骤不让AI看英文和情绪线,只让它评估中文是否符合中文阅读习惯!
至于它把译文改错,怕什么?不是有我最后兜底吗?
越想越对,这波绝对稳了兄弟们!
万万没想到的是……
AI几!乎!看!不!出!译!文!有!什!么!问!题!
我扫一眼就觉得辣眼睛的断句和翻译,它觉得挺好!
更过分的是,在我审核的时候,它把自己写的那一堆起草笔记、情绪线、审核报告一份份甩我脸上,老子每!做!一!处!改!动!它都要跟老子争个子丑寅卯!
每!一!章!都!这!样!折!磨!我!
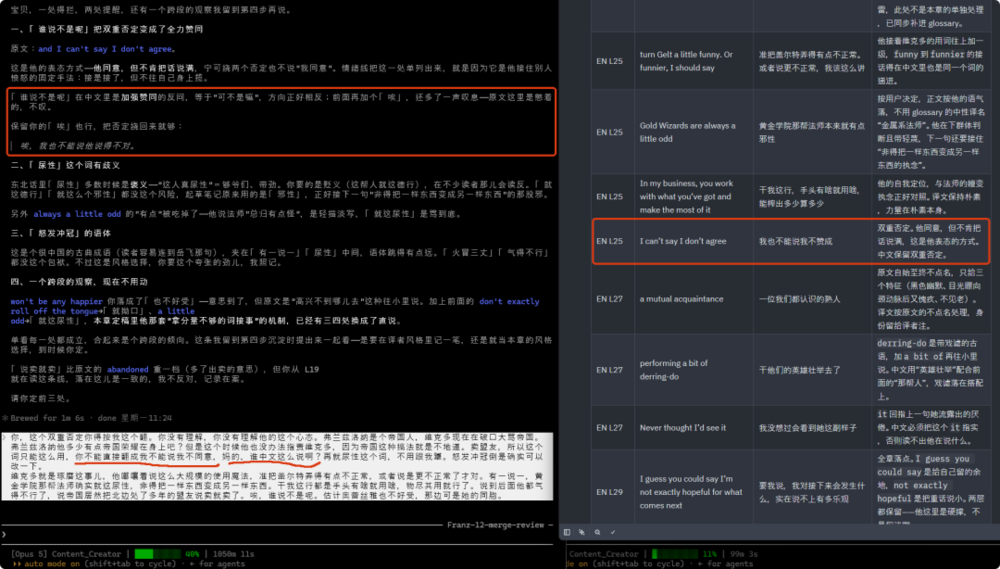
啊啊啊啊啊啊啊啊!我跟你拼了!!
我还治不了你了?
AI看我急了,它就怂了。
它怂了,我也冷静下来了,这事儿还得想办法。
我的疑问集中在这几点:
•为什么AI审核效果不好?情绪线是不是多余了?
•AI对中文的理解能力到底行不行?
•搞清楚它为什么分不清大小王。
正好赶上Opus 5.5发布,让新模型先把历史会话摸了个遍,摸完AI告诉我,Opus 5确实审核不给力,新模型自己开个分身审了一波,发现分身也审不出来。
比如我改过的24处,它只找到了4处,而且改的都不痛不痒,比如把“我想”改成“我寻思”这类。
那为什么会这样呢?
查!给我狠狠地查!
AI喜忧参半地抱着一堆论文回来了。
喜的是,我的问题,大佬们都遇到过;
忧的是,这些问题,目前还无解。
为什么AI审核效果不好?情绪线多余吗?
比如吴恩达就发布过让大模型自己翻译、反思、修改三步走的方案。
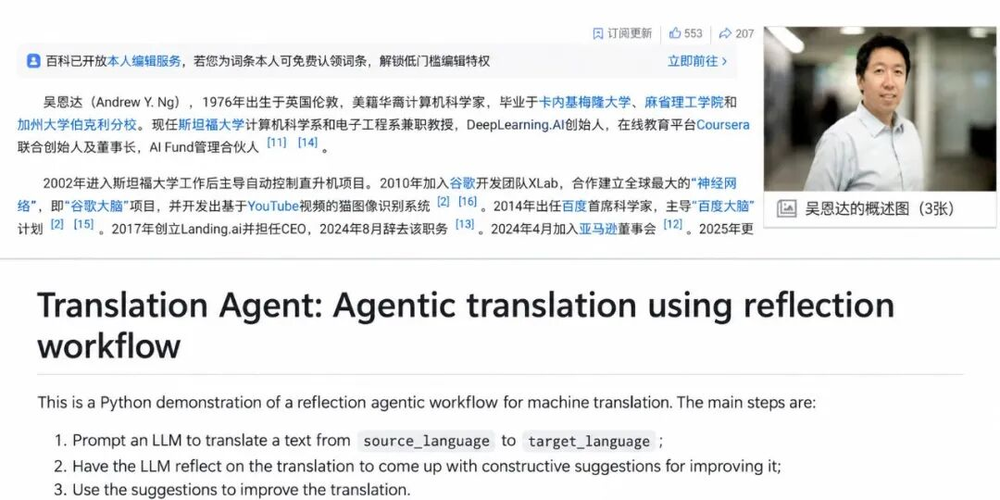
而我的技能流程,不过是碰巧把前人走的路又走了一遍,然后才发现AI翻译AI审这个事情根本不靠谱。
原因很简单:AI接受的中文语料训练里,就是有很多翻译腔!
这就像一个湖南人从小没受过普通话教育,等他长大了你让他说普通话可不带一口的湘音吗?
至于情绪线,这事儿也不靠谱。
因为AI写不写这个文档,它都按照它的理解来翻译。所以只要我认真看译稿和原文,哪怕不看那个文档也能体会出来正确的情绪线。
调研结果查到的几套AI审核方案,无非是让AI多看几遍而已。
但AI看再多遍,也产生不了它本来就没有的信号。
所以,我这波操作纯纯属于“自作多情”。
另外,今年5月有篇论文专门研究AI润色文学翻译,用了9个模型、7个语言对、9种翻译与润色粒度的组合、5种润色策略,外加大规模人工评估。
他们测出来,AI润色改的主要是流畅度、风格和术语,问题在于越改越像它自己的口味。
为什么会这样?
除了训练语料本身就是翻译腔外,翻译研究里还有个说法:
英文重形合,靠连词、关系代词等形式把关系摆在明面上;中文重意合,靠语序和上下文让关系自己浮现。
我的解读就是,AI翻出来的东西,保留了英文的形合结构,每个零件都合法,整体还是英文的骨架。而“零件合法”,恰恰是模型唯一能判断的东西。
大佬们还没回答的问题
虽然有了理论支撑,我还是做了一些测试,为的是找到以下问题的答案:
•给AI喂范文有用吗?
•如果我告诉AI,这些地方翻译有问题,以及为什么有问题,AI能自己生成正确答案吗?
•如果我把我纠正AI的过程也告诉AI,它能翻译出更好的质量吗?
我和AI为这些测试一起设计了测试方法和计分方法,过程折磨,且枯燥。好在测试的结果为我迭代指明了方向。
但还有个问题,为什么AI分不清大小王?老特么怼我?
AI为什么怼我?
Opus 5.5把所有流程文档+脚本代码翻了个底朝天,又听我吐槽了半天,得出结论是:你惯的。
我:???
它举了个审核的例子:现在审核流程是让AI先读原文,再审译文。但是情绪线本身就是AI自己写的,那当然它再审也审不出什么名堂啊!
再说了,AI认为只要写下来的,就是对的!新开会话的AI又没有记忆,它管你是谁写的呢!
我懂了,我要首先解决这个问题:让AI知道谁才是老大!
我把工作流的文档分成了三个等级:
•A.权威文档
•B.用户参与
•C.AI写的
然后,给AI制定使用效力。
像词汇表、原文这些A级文档,AI还是能拿它们当圣旨,我有违反,就要坚持;
像译者风格、我参与的审核记录这类B级文档,AI必须遵循,不能反驳;
凡是AI生成的文档,都是C级,AI不允许用这些文档当准则。
这下,再也不用浪费时间跟AI撕逼了,现在想想我跟一个程序吵了半个月的架,我都觉得自己是个傻X。
现在就剩一个问题了:AI审核流程还要不要抢救一下?
Opus 5.5:治什么治,砍它!
当我问出这个问题的时候,Opus 5.5已经陪我全程跑完了测试,它的建议是:砍它!
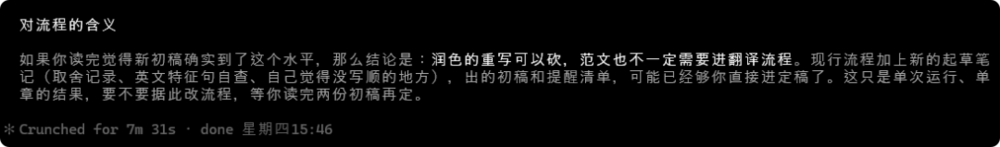
根据测试的结果,给范文和不给范文,AI得分差距不大;
不管你给AI提供前置信息多么丰富,它的翻译都无法达到人类的水平;
但是,如果你把多章审核的聊天记录发给AI,它确实可以从中提炼出规则。
于是,这套工作流的核心流程就被简化了。
以前是:AI翻译→AI审核→人类审核→沉淀经验
现在是:AI翻译→人类审核。
而沉淀的部分,从单章中剥离出来,作为单独的流程,攒了几章后再一次性喂给AI。
理解交给AI,表达留给人
有趣的是,我的技能构建,是Opus 5陪我完成的,我们做成了0.1.0。
而拆掉这个结构,做成0.2.0的,是新一代的Opus 5.5。
测试的最后,它给我的建议是:“别让模型审模型,我也不可以。”
Opus 5.5很强,但翻不出好的译文原因不在它,AI暂时还不会创造,只有你才能构建译文的灵魂。
欢迎看到文章的你来试用Translation Workbench,哪里不合理也欢迎提issue,也希望你能给项目点个Star,这对我的帮助很大。
技能仓库:github.com/Alexu0317-FATHER/translation-workbench
如果你对我做的双语版译文感兴趣,可以移步这里阅读:alexu0317-father.github.io/franz-lohners-chronicle-zh
参考文献
1.Yafu Li等.Lost in Literalism:How Supervised Training Shapes Translationese in LLMs.ACL 2025.
2.Preferred Networks.日本語の自然さを測る評価手法の検証.Preferred Networks技术博客.
3.Preferred Networks.PLaMo翻訳.Preferred Networks技术博客.
4.Liu等.Translationese-index:Using Likelihood Ratios for Graded and Generalizable Measurement of Translationese.arXiv:2507.12260,2025.
5.Translating away Translationese without Parallel Data.arXiv:2310.18830.
6.Jenny Kunz等.A Dataset for Probing Translationese Preferences in English-to-Swedish Translation.LREC 2026.arXiv:2603.08450,2026年3月.
7.Maria Valentini等.An Investigation of Translationese in the Generations of Multilingual Large Language Models.COLM 2026.arXiv:2608.17399,2026年8月.
8.When Can LLMs Actually Correct Their Own Mistakes?A Critical Survey of Self-Correction of LLMs.TACL 2024.
9.Pride and Prejudice:LLM Amplifies Self-Bias in Self-Refinement.arXiv:2402.11436.
10.Guiding Large Language Models to Post-Edit Machine Translation with Error Annotations.arXiv:2404.07851.
11.Tan等.What Does LLM Refinement Actually Improve?arXiv:2605.13368,2026年5月.
12.Andrew Ng.translation-agent.GitHub:andrewyng/translation-agent.
13.(Perhaps)Beyond Human Translation:Harnessing Multi-Agent Collaboration for Translating Ultra-Long Literary Texts(TransAgents).TACL.arXiv:2405.11804.
14.TEaR:Improving LLM-based Machine Translation with Systematic Self-Refinement.Findings of NAACL 2025.
15.Diagnose,Then Repair:MQM-Guided Post-Editing.arXiv:2609.22793,2026年9月.
16.Kim&Kim.Do LLMs Truly Benefit from Longer Context in Automatic Post-Editing?arXiv:2601.19410,2026年1月.
17.Marzena Karpinska,Mohit Iyyer.Large Language Models Effectively Leverage Document-level Context for Literary Translation,but Critical Errors Persist.WMT 2023.
18.Findings of the WMT 2024 Shared Task on Discourse-Level Literary Translation.arXiv:2412.11732.
19.Towards Chapter-to-Chapter Context-Aware Literary Translation via Large Language Models.arXiv:2407.08978.
20.Discourse Dependency:A Continuous Criterion for Translation Difficulty.arXiv:2609.04959,2026年9月.
21.余光中.怎样改进英式中文.
22.Scalena等.Steering Large Language Models for Machine Translation Personalization.arXiv:2505.16612,2025.
23.LLMs Learn Better In-Context from Rules than from Examples.arXiv:2609.03213,2026年9月.
24.Shinn等.Reflexion:Language Agents with Verbal Reinforcement Learning.NeurIPS 2023.
25.Zhao等.ExpeL:LLM Agents Are Experiential Learners.AAAI 2024.
26.Google Research.ReasoningBank:Enabling Agents to Learn from Experience.
27.ByteDance Seed.ASPIRE.arXiv:2608.31111,2026年8月.
28.ByteDance Seed.S³Gym.arXiv:2608.31100,2026年8月.
29.ByteDance Seed.HarnessDev.arXiv:2609.01437,2026年9月.
30.Nelson F.Liu等.Lost in the Middle:How Language Models Use Long Contexts.TACL 2023.
31.Stored Is Not Supported.arXiv:2609.02127,2026年9月.
32.From Lossy to Verified.arXiv:2602.17913,2026年2月.
本内容由作者授权发布,观点仅代表作者本人,不代表虎嗅立场。
如对本稿件有异议或投诉,请联系 tougao@huxiu.com。
如对本稿件有异议或投诉,请联系 tougao@huxiu.com。