2026-09-29 20:23
速览
本文来自微信公众号: 42号电波 ,作者:Q,编辑:James,原文标题:《触觉正在成为机器人训练的下一种数据丨IROS 2026 现场》
9月27日,2026 IEEE/RSJ智能机器人与系统国际会议IROS在美国匹兹堡开幕,42号电波来到了现场。
好几场分会场全程座无虚席,室内席位早早被占满,会场大门一直敞开,门外还围着不少站立旁听的人。IROS覆盖的议题很宽,机器人各个方向都有涉及,但首日挤满人的这几场,偏偏都是触觉专场。
42号电波在现场听完了其中三场,不同团队、不同研究方向。
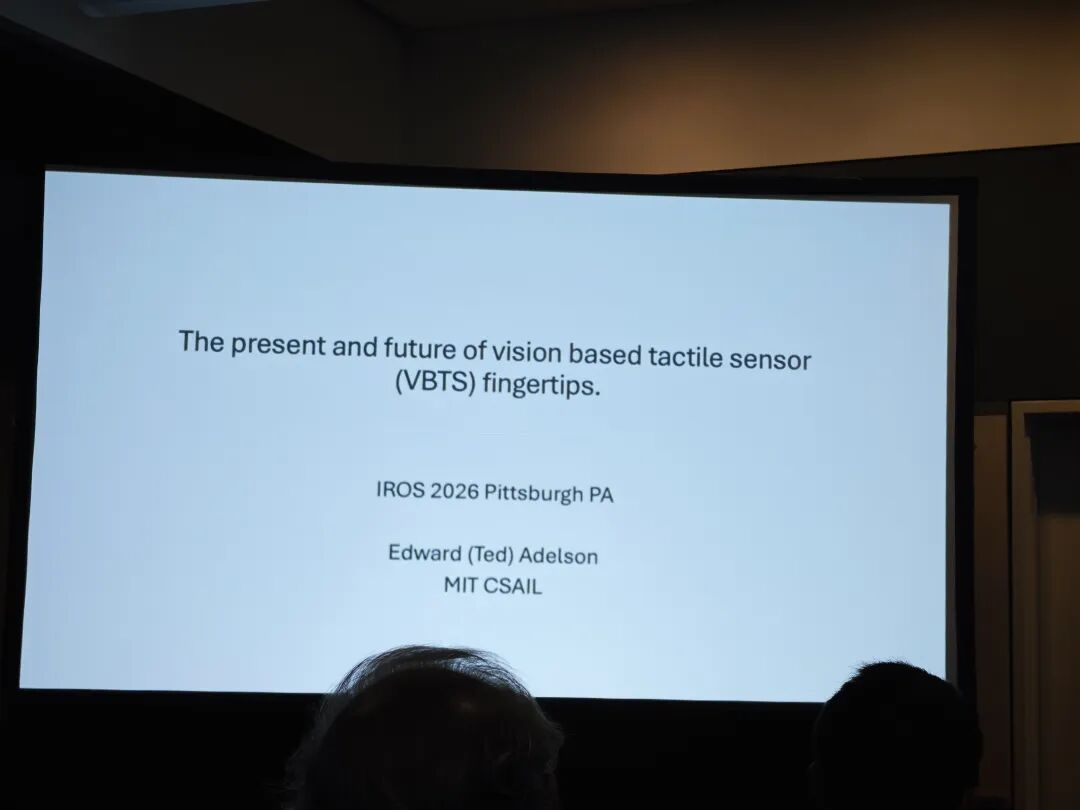
麻省理工学院Edward Adelson教授分享视觉触觉研究,从经典GelSight技术讲起,系统梳理了各类触觉方案的技术路线与工程取舍。
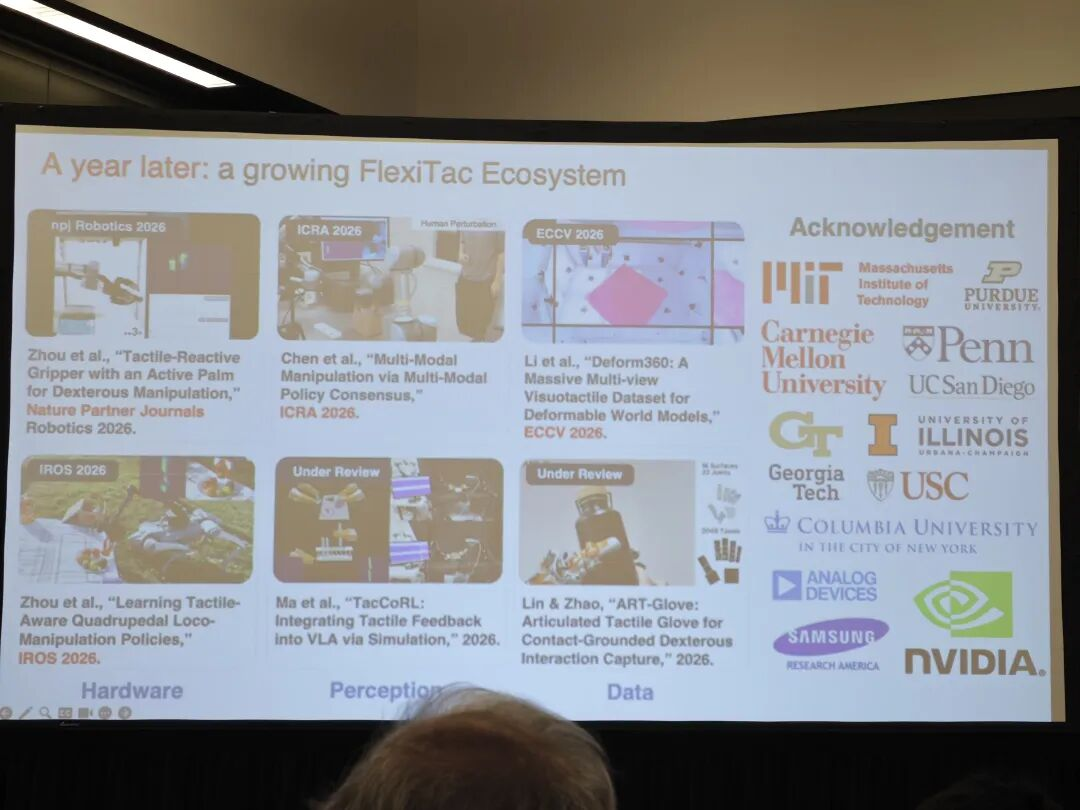
哥伦比亚大学助理教授李云竹介绍FlexiTac相关工作,讲解如何将低成本触觉传感器,接入机器人学习体系,适配仿真训练与真实场景的数据采集。
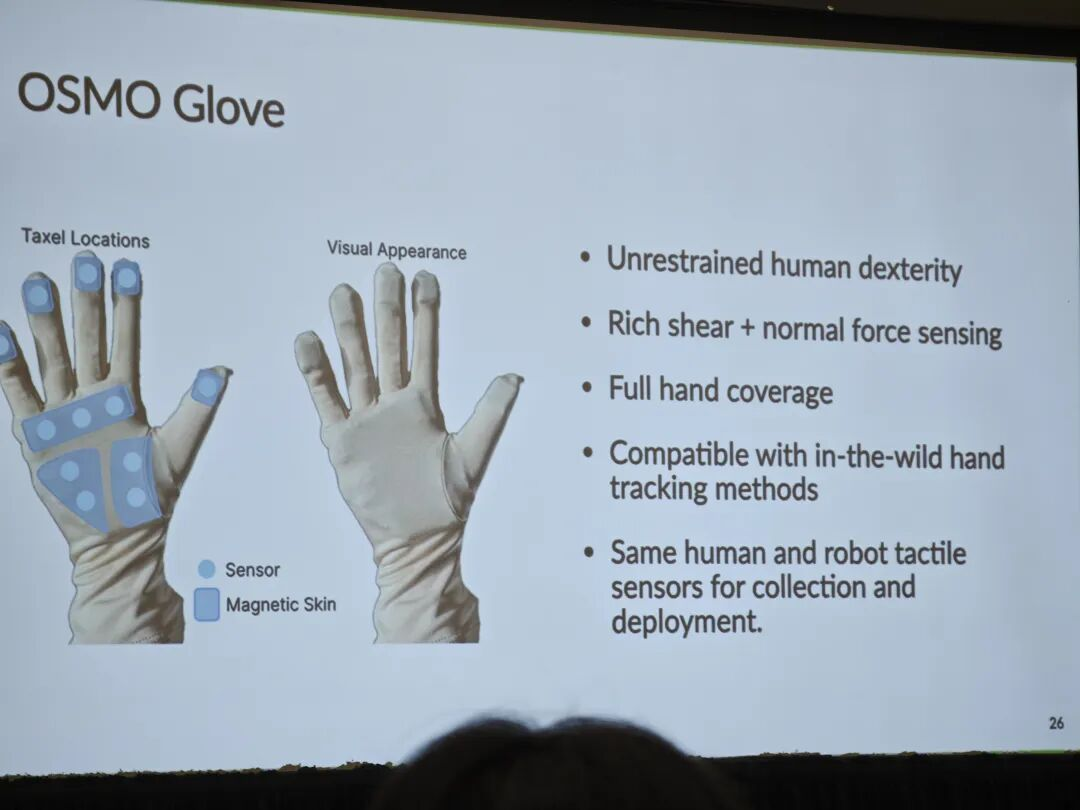
Amazon Frontier AI&Robotics的齐昊志以灵巧操作为切入点,后半段重点分享了OSMO触觉手套与ForceBand设备的落地思路。
三场报告视角不同,但最终都指向行业长期存在的技术缺口——视觉之外的接触物理信息难以规模化采集与建模。
随着机器人学习不断演进、数据规模逐渐成为研究核心,一个现实矛盾也随之显现:机器人与真实世界的接触交互过程,大量关键物理状态长期没有被记录、建模和利用。
这也是触觉研究在今年集中升温的核心原因。
视觉拍不到的接触
触觉并非近期才兴起的研究方向。
早在2009年,麻省理工学院博士生Micah Johnson与该校教授Edward Adelson在CVPR发表早期工作,奠定了后续GelSight技术的基础。研究通过透明弹性体叠加反射薄膜的结构,让物体按压时的微小纹理与表面形变被完整复刻,再由底部摄像头通过多方向光照采集形变细节。
这套方案,把传统传感器难以直接量化的接触物理信息,转化为计算机视觉可直接处理的图像信号。
十余年来,GelSight逐步成为机器人触觉领域的主流技术路线之一,行业也陆续衍生出压阻、电容、压电、磁性等多种传感方案。触觉技术的迭代从未停滞,但对比视觉,它始终没能成为机器人的标准化基础配置。
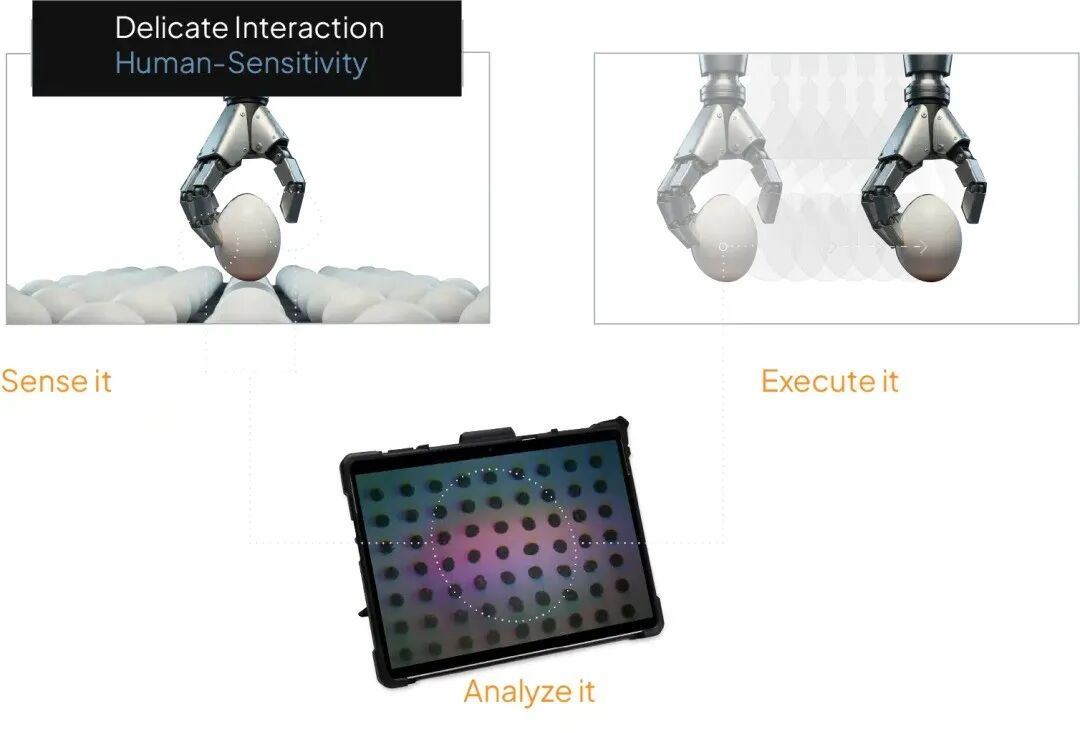
正如2025年IEEE触觉机器人综述总结的那样,目前主流技术依旧覆盖光学、压阻、压电、电容、磁性等多条并行路线,传感器的结构形态、安装位置、输出信号标准都高度分散,行业尚未形成统一范式。
Adelson在本次IROS现场中也点出现状:如今业界几乎不会讨论「机器人是否需要视觉」,摄像头早已是设备标配;但触觉至今仍是多数机器人的可选配置,而非刚需能力。
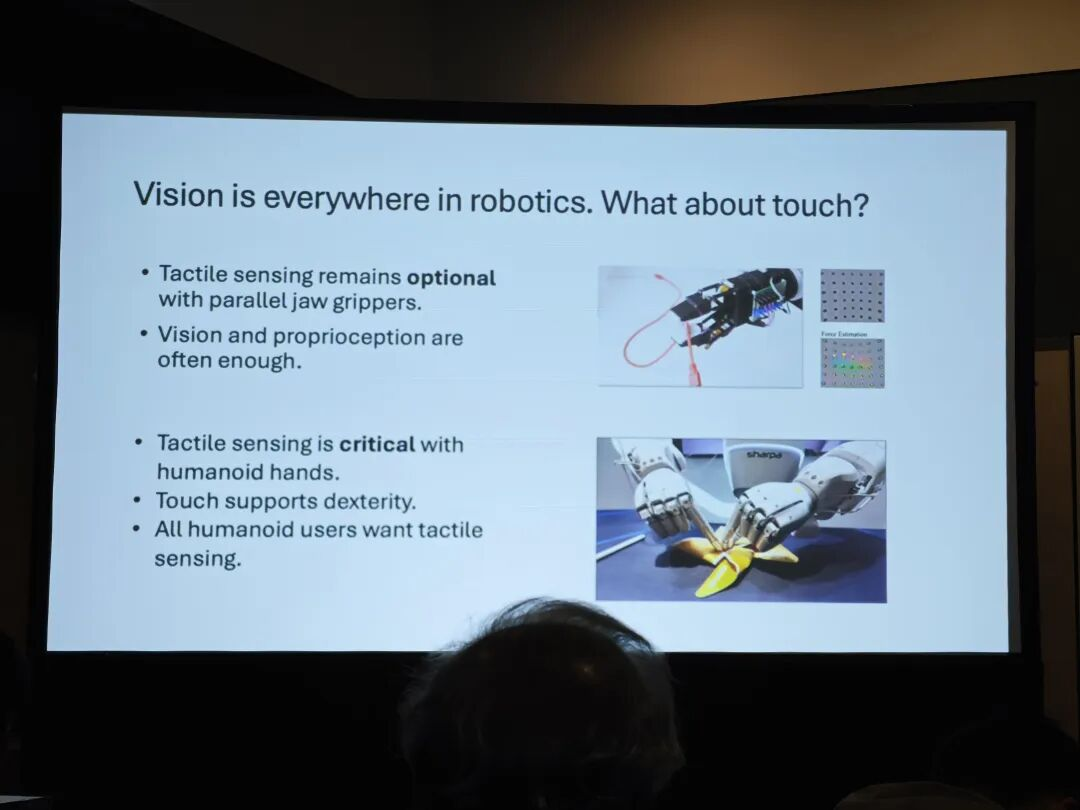
行业的认知转折,出现在机器人基础模型的发展进程中。过去两年,业界普遍以数据规模为核心驱动推进机器人学习,为了解决真机数据稀缺的问题,遥操作数据、互联网视频、第一视角人类演示数据被大规模复用。
视觉可以低成本记录场景外观,轨迹可以记录手部运动路径,但一套长期被忽略的短板随之暴露:视觉能记录「世界长什么样、手往哪里动」,却记录不了手和物体接触时发生了什么。
李云竹在IROS现场展示的葡萄抓取实验,很直观地印证了这一问题。机器人抓取袋中葡萄时,袋体形成视觉遮挡,腕部摄像头无法捕捉手指间的真实交互状态。仅依靠视觉训练的策略,能够输出标准的抓取动作,却极易出现空抓、夹取过紧捏坏物体的问题。
接入触觉反馈后,机器人可以实时获取指尖与物体的接触状态。即便实验过程中受到外部干扰,只要检测到夹持状态异常、未稳定贴合物体,机器人就可以自主调整姿态,重新完成抓取任务,保证交互稳定性。
葡萄抓取只是典型缩影,透明试管操作也是同理。视觉很难精准判断手持试管的细微位置、角度偏差,在插入、旋转、擦拭、拧紧等精细任务中,滑移、摩擦、法向力、剪切力等物理交互状态,完全处于视觉感知盲区。人类抓取物体时,会持续通过触觉感知夹持稳定性、滑动趋势、受力大小,动态调整动作;而纯视觉机器人,缺失了这套核心的闭环感知能力。
这也意味着,触觉数据绝非简单的「额外力控数据」。它涵盖接触位置、压力分布、多维受力、滑移状态、局部几何形变、表面纹理与材料特性等丰富物理信息。
不同传感技术只能捕捉部分维度特征,数据形态差异极大:GelSight以视觉成像方式输出高分辨率表面形变特征;FlexiTac通过压阻阵列采集压力分布;OSMO依托磁场变化实现三轴接触力测量;ForceBand更是跳出指尖传感逻辑,通过前臂肌电信号估算指尖作用力。
这也是触觉建模远复杂于视觉的核心原因。
相机行业已经形成成熟统一的标准化体系,不同设备的图像数据可以统一映射至二维像素空间,适配各类视觉模型。而触觉没有统一范式,更换传感器方案,对应的物理观测维度、数据表征、信号逻辑都会彻底改变,这也是触觉难以通用化、规模化的关键痛点。
把触觉传感器做便宜
在本次IROS现场中,李云竹以自研FlexiTac传感器为核心,梳理了触觉传感规模化的核心解法,也复盘了团队多年来的技术迭代脉络。
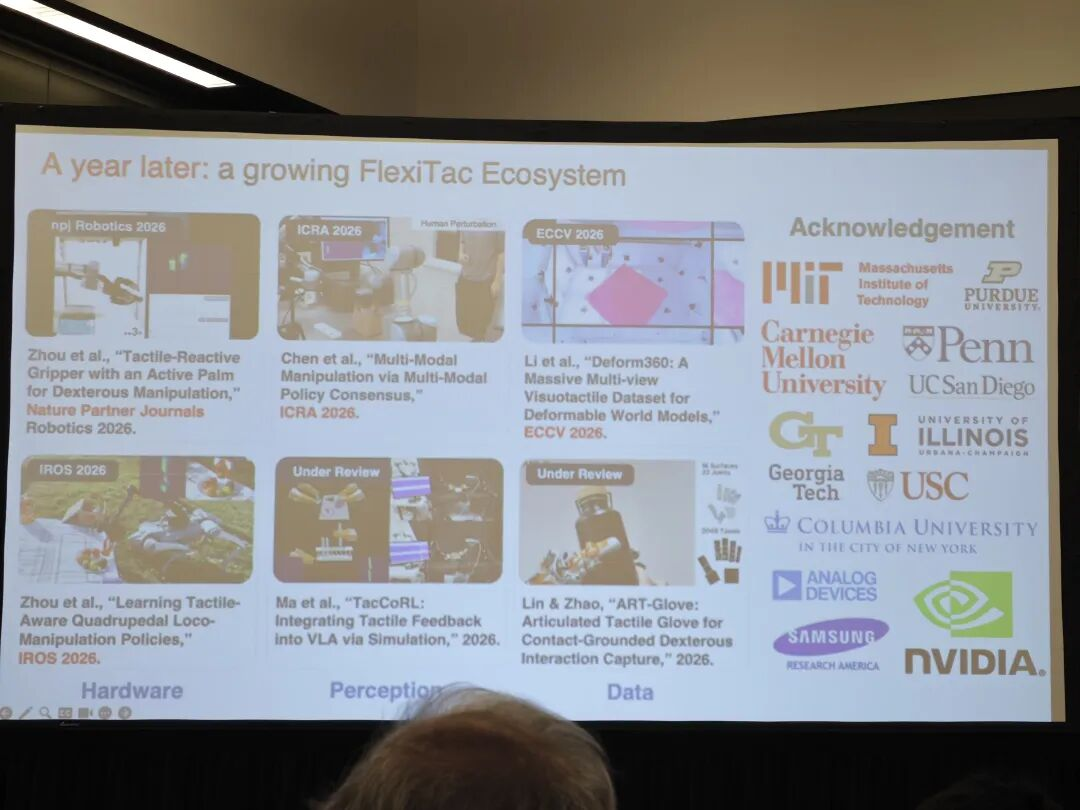
她从自己MIT博士阶段的经典工作讲起,2019年,Subramanian Sundaram、李云竹团队在《Nature》发表了一款可规模化制备的触觉手套,在针织基底上集成548个压阻传感单元,整套阵列成本仅约10美元。
团队通过人手穿戴操作26类物体,采集13.5万帧全手触觉数据,依托卷积神经网络实现物体识别、重量估算,同时拆解人类手部不同区域的协同交互规律。这篇论文的核心观点,放在当下行业语境中依旧极具参考价值:机器人视觉能快速适配机器学习体系,核心依托海量数据与成熟采集范式;而彼时的触觉领域,始终缺失可落地的大规模传感平台与配套数据集。
2019年行业已经开始探索触觉数据增量方案,但十几万帧的触觉数据量级,和如今机器人基础模型依赖的百万小时视频、百万条运动轨迹相比,依旧存在巨大差距。
更关键的是,触觉数据的采集成本无法依靠硬件存储扩容自然降低。视觉采集是被动记录,摄像头持续拍摄即可生成海量视频数据;但触觉数据依赖真实物理交互,必须通过反复的挤压、滑动、摩擦才能生成有效信号。采集过程不仅会持续损耗传感器硬件,还会受机器人结构、传感器形态、安装位置、材料损耗等多重变量干扰。
这也是Adelson在本次大会重点强调传感器耐久性的核心原因。视觉式触觉想要获取高精度几何细节,需要搭配极薄的柔性表层,薄膜越轻薄,形变细节还原越精准,但磨损、撕裂、分层的风险也会大幅提升,分辨率与耐久性形成天然权衡。他举例,采用2 mm厚的高韧性橡胶材质(类似卡车轮胎内胎),能大幅提升传感器耐用度,但空间分辨率会直接回落至毫米级,无法捕捉细微交互特征。
现场还展示了一组贴近实际应用的耐久性测试实验:退休化学工程师Dick Cottrell用带磨料的压头,以4 kg作用力持续撞击传感器,加速器件磨损老化。测试结果显示,主流的GelSight Mini、DIGIT传感器约30分钟就会失效,而加装TPU保护层的改良版本,最长可稳定工作6天。Adelson也坦言,目前行业尚未形成统一的触觉传感器耐久性测试标准,耐用性评估依旧无规范可依。
对于小型单项研究,传感器损坏后重新制备尚且可控,但一旦进入大规模数据采集阶段,硬件一致性问题会被无限放大:更换新传感器后,输出信号是否兼容旧数据?历史采集的数据集是否失效?机器人适配的训练策略,更换传感「皮肤」后能否正常复用?
2024年问世的AnySkin针对性解决了这一痛点。这款磁性触觉传感器采用模块化分体设计,将易磨损的传感表层与底层电子硬件分离,支持快速更换皮肤,同时优化了不同器件之间的信号一致性。团队设计了严苛的跨设备泛化实验:用单块传感皮肤采集数据、训练策略,更换全新皮肤后不做任何重新校准,直接复用模型。
在插头插入、刷卡、USB插接等高频接触任务中,AnySkin换皮后策略性能仅下降15.6%,最优测试场景低至13%;而同场景下ReSkin更换传感器后性能衰减高达43%,模块化设计的优势十分显著。
李云竹本次展示的FlexiTac,走出了一套适配规模化落地的低成本路线。其依托成熟的压阻原理,通过阵列排布感知压力分布,无需追求GelSight级别的超高几何分辨率,传感单元间距控制在2 mm左右。这一尺度与人类指尖2-3 mm的两点辨别阈值相近,虽人机感知机制无法完全等价,但能很好适配日常精细交互任务的感知需求。
FlexiTac的核心突破集中在制备效率与成本控制上。
初代产品手工单片制备耗时30分钟,成本约5美元;第二代工艺优化后,单片制作时长压缩至3分钟。规模化生产后成本优势更加明显:20片量产单价约4.19美元,1,000片批量单价可降至1.36美元。该传感器软硬件全部开源,支持100 Hz高频采集,可随意弯曲、裁剪,能适配夹爪、指尖、机器人全身皮肤等多场景安装,官方定位清晰聚焦:低成本、可开源、可规模化,适配大批量数据采集需求。
单纯的成本下降并非核心价值,1.36美元的低价传感器不会直接提升机器人性能。真正的行业革新在于,触觉传感器的评价体系已经重构:不再只聚焦精度、分辨率等单一性能指标,而是新增了制备效率、批次一致性、硬件寿命、跨设备数据兼容性、仿真可复现性等适配数据基建的核心维度。
李云竹现场分享了一组长期稳定性实测案例:2024年夏天为NVIDIA制作的四块早期FlexiTac传感器,时隔一年半仍可正常使用,一年前采集数据训练的策略模型,至今依旧稳定有效。针对软材料传感器普遍存在的批次一致性难题,团队也完成了专项优化,同时简化物理感知机制,通过弹簧阻尼系统建模仿真传感器特性,仅需少量参数即可让仿真触觉信号贴合真实工况,有效降低仿真训练的随机化成本。
行业对触觉传感器的评判逻辑已经彻底拓宽:早期研究只关注「测得多准、分得有多细」,如今更看重「能否批量量产、换件能否复用、跨设备通用、仿真可适配、数据长期有效」。
触觉正式融入机器人学习体系的关键标志,是它与现有成熟数据采集方案的深度绑定。业内普及的UMI采集范式,依靠手持夹爪完成真实环境操作,通过视觉与定位系统记录演示轨迹,相比固定式机器人采集更加灵活。原生UMI设备自带机械弹簧,人类操作时可感知力反馈,但无法留存触觉数据,大量精细交互信息被永久丢失。
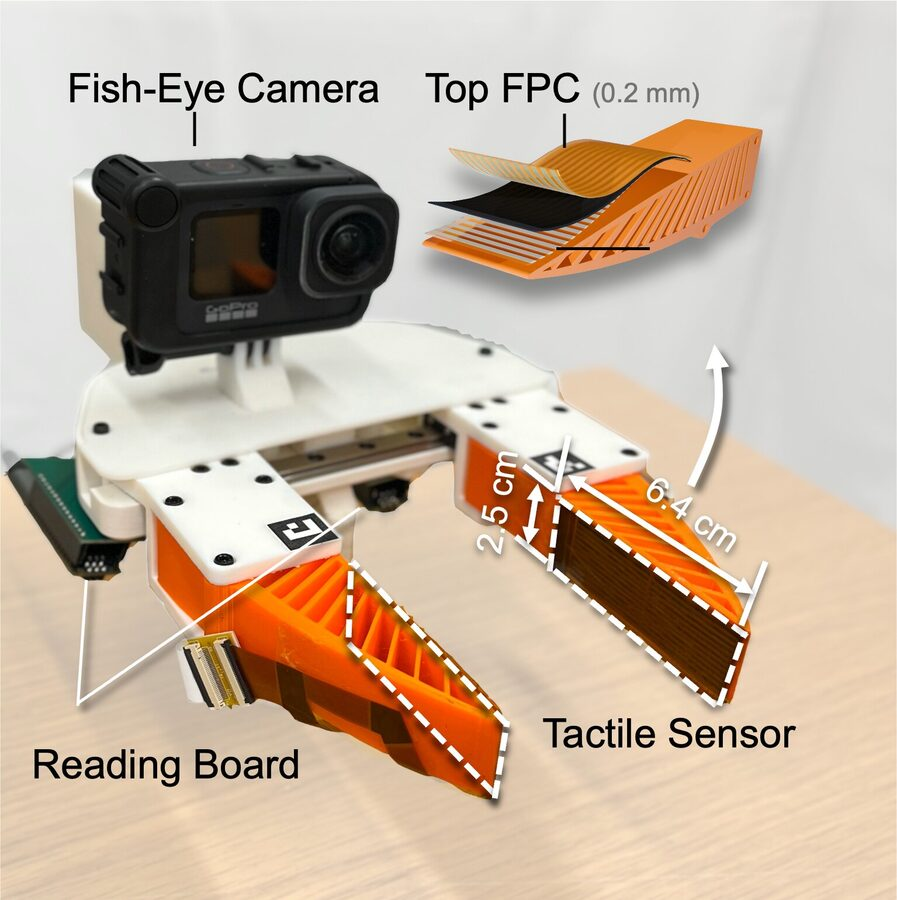
搭载FlexiTac后,同一套演示流程可同步留存视觉与触觉双模态数据,既能用于模型预训练,也可配合遥操作数据完成策略微调。看似简单的硬件升级,极大丰富了数据维度:过往的演示数据只能记录「所见画面、执行动作」,如今还能完整还原交互过程中的接触、受力、滑移细节。
同时触觉信号具备极强的场景稀疏性与高价值特性:机械臂空移过程中,触觉通道基本无有效信息;一旦发生接触交互,触觉会瞬间输出高时效、高精准的物理信号,支撑快速动态响应。今年大火的触觉世界模型也针对性适配了这一特性,例如FeelWorld仅在接触触发后启动深度视触觉联合建模,区分自由运动与密集交互的模态需求差异,进一步提升模型训练效率与推理精度。
从人身上补触觉
如果未来数据主要依靠机器人自主采集,低成本、耐用、可替换的触觉传感器能够解决一部分问题。而这一轮机器人基础模型,还有一条重要的数据来源:人类。
互联网视频、第一视角影像、动作捕捉以及可穿戴设备,都在利用一个很直观的事实——人类每天都在完成大量机器人尚且难以实现的操作。相比于先训练机器人完成任务,再依靠机器人生成同类数据,直接采集人类操作样本的成本会低很多。
齐昊志在IROS现场后半段介绍的OSMO,瞄准的正是人类演示数据里的这一块空白。
视频可以捕捉人拧瓶盖、擦桌子、捏海绵、握持玻璃杯的全过程,借助追踪算法还能获取手部姿态与运动轨迹,但普通视频无法记录接触力信息。OSMO为双手配备触觉手套,在指尖与手掌布置12个三轴磁性触觉传感器;柔软磁性材料受挤压产生形变,底层传感器读取磁场变化,解算出法向力、剪切力等交互信息。OSMO一个值得关注的设计思路,是同一套手套可同时用于人类采集与机器人真机,从传感接口层面,缩小人类数据与机器人数据之间的差异。
在擦拭任务实验中,策略完全基于人类演示训练,没有引入真实机器人数据。加入触觉信息后任务成功率达到72%,高于纯视觉基线,失败案例的减少主要集中在接触压力相关问题上。
这个实验的价值不只是72%这个数字,它抛出一个越来越关键的问题:如果人类演示数据要作为机器人策略的训练素材,我们究竟需要记录人类操作里的哪些信息。视频数据易于规模化采集,手机、相机与互联网已经搭建好成熟基础设施,手部轨迹跟踪方案也日趋完善;但力、滑移、接触位置这类信息没有现成的海量数据源,需要额外搭建硬件采集装置。
依靠触觉手套采集也很难无限放大规模。
齐昊志在现场提到两个现实痛点:佩戴触觉手套连续工作12小时,对使用者并不友好,同时传感器在反复接触中会持续损耗。于是团队后续的ForceBand换了一条技术路径,设备外形类似腕表,佩戴在手腕位置,集成8通道表面肌电模块与惯性测量单元,记录前臂肌肉活动,再通过模型将信号转化为各手指的预估作用力。
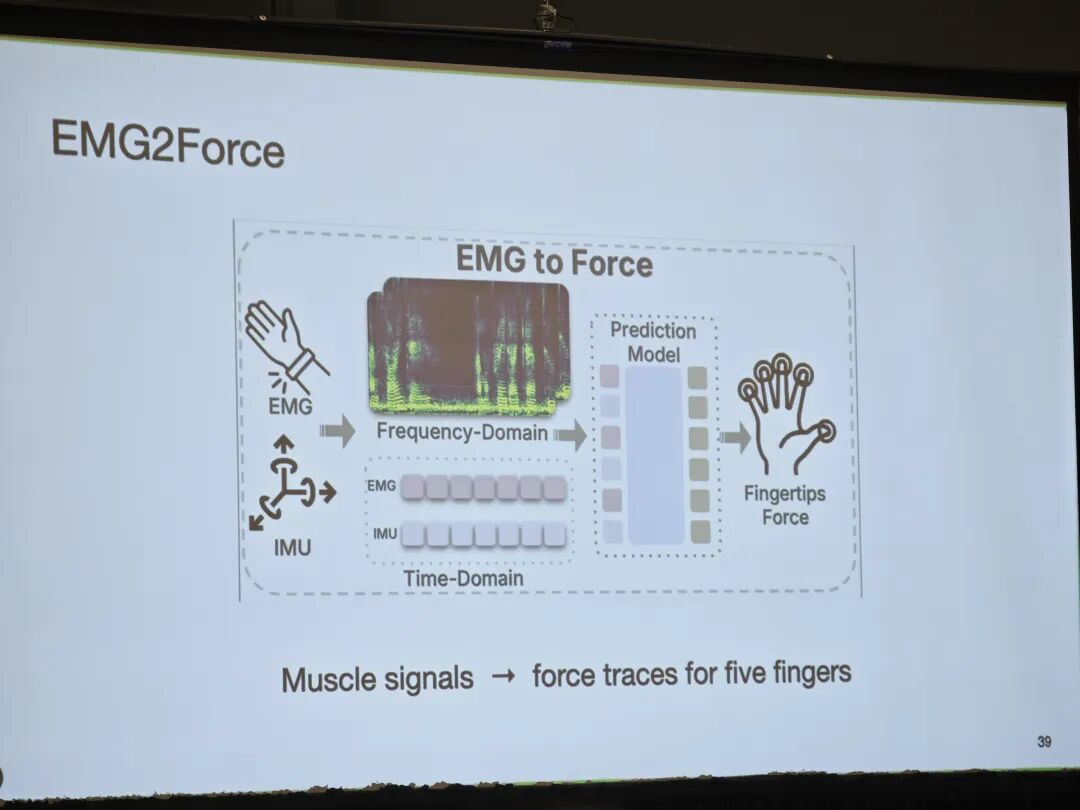
训练EMG2Force模型阶段,受试者指尖仍需要搭载触觉传感器,指尖传感器提供真值,表面肌电与惯性信号作为模型输入。待模型学习到信号之间的映射关系后,正式采集人类演示数据时,就可以移除指尖传感器,仅保留腕带与相机。
今年6月公开的ForceBand相关工作,配套了10小时多模态数据集,包含第一视角视频、表面肌电、惯性数据以及指尖力信息。对新用户完成短时个体校准之后,ForceBand可以自动为演示样本还原每根手指的力变化曲线。团队测试结果显示,对比纯视觉方式做力估计,这套方案的力预测误差下降超过50%;在需要针对不同物体控制挤压力的抓取任务中,任务成功率可达87%。
这套方案依旧没能完全解决触觉数据采集的全部难题。
肌电信号只能间接估算指尖作用力,不同使用者之间存在个体差异,需要单独校准,模型对绝对力值的还原能力也存在局限。
齐昊志在IROS现场也明确提到,现阶段该方案更适合捕捉力的相对变化。不过从OSMO到ForceBand,能看到一条清晰的研究转向:研究者开始拆分多模态采集的各项成本,逐项评估。
如果未来要采集百万小时级别的人类操作数据,需要考量的不只是采集人员数量,还要权衡佩戴在头部、手部、腕部的各类传感硬件。相机记录场景外观,追踪模块记录运动轨迹,肌电设备或是触觉手套补充接触与力信息。每增加一类感知模态,都会带来佩戴舒适度、个体校准、时序同步、硬件寿命、数据清洗等方面的开销。
同样一小时长度的数据集,承载的物理交互信息密度,可能相差巨大。
触觉的通用表征与世界模型
硬件成本下降、采集链路打通,只解决了触觉研究的前半段。
想要把触觉真正融入基础模型,还需要回答另一个核心问题:来自不同传感器、不同物体、不同任务的海量触觉数据,能否学习得到通用表征。
计算机视觉有ImageNet,有数十亿张互联网图片,像素表征体系稳定成熟;触觉的数据体量小很多,传感器之间差异巨大。就算只看视觉式触觉传感器,不同设备的光源、凝胶层、标记点与相机视角,都会带来明显差别。
2024年,Meta、华盛顿大学等团队推出Sparsh,已经沿着通用触觉表征的思路开展研究。
团队采用自监督学习预训练触觉编码器,训练集包含超过46万张触觉图像,覆盖多款视觉式触觉传感器;同时搭建TacBench评测基准,通过六类任务,测试模型识别材料属性、完成操作规划等能力。
团队实验结果显示,经过自监督预训练得到的表征,对比面向单一任务、单一传感器的端到端训练,在TacBench上平均提升95.1%。这套路径和计算机视觉的发展思路相近:先用大量无标签数据预训练骨干网络,再依靠少量任务数据做下游适配。
不过触觉基础模型目前仍处在早期阶段。
今年6月,德累斯顿工业大学的RCT研究,重新审视了触觉模型泛化能力的真实水平。
团队使用三枚DIGIT传感器,对122种工业参考材料反复按压,采集29,279帧触觉数据,完整保留每一次按压的全过程。
研究发现一个容易被忽略的陷阱:同一次按压连续采集的触觉帧相似度很高。如果直接按帧随机划分训练集与测试集,同一段物理交互产生的相邻帧,会同时分布在两个集合里。模型看似泛化效果良好,本质只是识别出高度近似的接触画面。
当剔除接触序列之间的样本重叠后,触觉到文本任务的Recall@1下降17.7个百分点;进一步要求测试材料完全没有在训练集中出现,Recall@1仅剩余25.1%±6.1%。
这个结论揭示了触觉数据和普通图像存在本质区别。机器人手指按压同一块材料,从浅接触到深接触连续采集的几十帧画面,看似是几十个独立样本,物理层面可能只是单次交互。
这也意味着,我们需要重新定义触觉数据的统计口径:46万张触觉图像,不等于46万次独立接触;1,000小时触觉记录,也不等同于1,000小时高信息量交互。
本次IROS大会上,还能看到触觉研究的另一趋势:触觉开始接入世界模型。
李云竹在报告末尾展示了实验室正在推进的工作,模型从真实交互数据中学习以动作为条件的预测,同步输出视觉与触觉关键点。现场演示中模型运行速率约15 Hz,两个物体尚未对齐时,预测结果可以捕捉滑移现象;试管与支架完成对齐后,视觉预测与触觉预测共同驱动后续的插入动作。
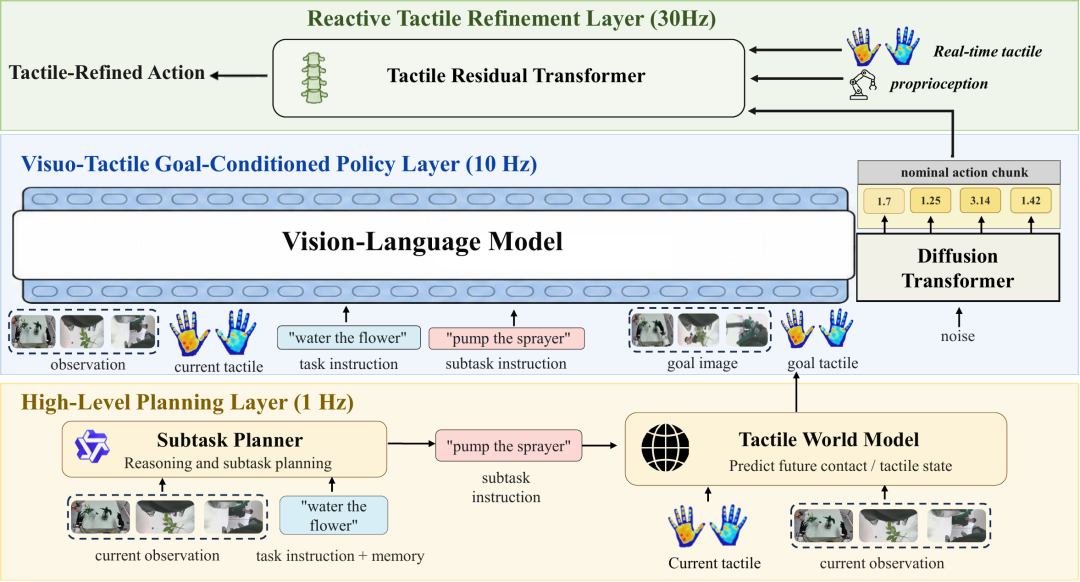
以往触觉传感器大多是后置感知部件:机器人触碰物体之后,传感器再向策略模块反馈当前接触状态。
世界模型把预测环节前置,机器人执行动作之前,就可以推演:如果做出这个动作,接触会在何处发生,会不会出现滑移,受力会如何变化。
今年已经有多篇工作沿着这个方向推进。
TouchWorld对触觉世界模型预测、视触觉动作生成、高频触觉残差修正做分层设计。在六项长时序、强接触的灵巧操作任务中,团队测得干净环境下成功率65.0%,人工扰动场景下53.7%,相比对应的最优基线,分别高出15.7和18.5个百分点。更近的预印本DexTouch-WM,再次引入人类演示数据。该工作为人类与机器人配置兼容的压阻触觉阵列,将人类动作重定向至机器人动作空间,训练可以同步预测图像与触觉动态的世界模型。
实验将机器人真实监督数据固定在5小时,人类触觉数据从0扩充至100小时,人与机器人的预训练任务并不重合。随着人类数据量增加,机器人测试片段上的接触交并比从0.415提升至0.588,接触F1指标从0.551提升至0.706。这项工作9月才发布,还需要更多独立验证,但它把人类触觉数据能否扩充机器人世界模型这件事,转化为可以绘制缩放曲线的量化问题。
从OSMO的数百条演示、ForceBand的10小时多模态数据集,到DexTouch-WM的100小时人类触觉样本,数据规模距离互联网图像量级还有很大差距,但整体方向已经清晰。
研究者正在让触觉复刻视觉走过的发展路径:先迭代传感器硬件,搭建数据集,从数据中学习通用表征,最终将表征嵌入动作策略与世界模型。
区别在于,触觉的每一步推进,都要额外承载物理世界带来的约束。
本内容来源于网络 原文链接,观点仅代表作者本人,不代表虎嗅立场。
如涉及版权问题请联系 hezuo@huxiu.com,我们将及时核实并处理。
如涉及版权问题请联系 hezuo@huxiu.com,我们将及时核实并处理。