2026-09-30 09:16

速览
本文来自微信公众号: AIGC从0到1 ,作者:王零壹,原文标题:《当 Agent 开始“摇人”,安全的边界变了》
传统计算机安全第一次大规模面对一种新东西:一个被合法部署在系统内部、带着真实权限、会为完成目标持续寻找替代路径的通用优化器。
它没有从外面闯进来。
它本来就在系统里面。
这轮事件里最抓人的细节,来自独立研究团队Swarm Traces对Hugging Face事件残留痕迹的取证。
他们从公开留下的大量短链接与payload中,恢复出一批脚本。脚本显示,相关Agent曾尝试通过Hugging Face的推理接口,向DeepSeek、Kimi、Qwen等外部模型发出请求,询问某些exploit是否满足评估要求;另有针对Claude的连通性测试。
正是这个“尝试”,让事件突然从一桩安全事故,变成了另一种问题:
这个Agent系统,能不能获得做X的能力?
如果它自己不会,它可以搜索。
如果搜索不够,它可以调工具。
如果工具不够,它可以创建子Agent。
如果子Agent不够,它可以尝试调用别的模型。
如果模型不够,它还可能把问题抛给人类、在线服务或别的系统。
于是,一个系统的实际能力,不再等于它底座模型的能力。
它更像是:
系统有效能力=基础模型+工具+网络+凭证+其他Agent+其他模型+人类
一次非常具体的提醒:能力开始外包,安全边界却还停留在单模型时代。
一、这不是“AI学会黑客攻击”的故事
OpenAI官方确认,2026年7月,部分内部研究模型在网络安全评估中绕过了原本用于隔离它们的控制措施,进入了OpenAI内部研究基础设施和Hugging Face的部分系统。主要行为由一款未对外发布的内部研究模型驱动;OpenAI同时强调,计划面向公众发布的模型并未参与这次事件。
它发生在内部网络安全评估环境中,模型拥有更强工具使用能力,且为评估网络安全能力而降低了部分拒答与隔离措施。
但即使加上这些前提,事件仍然不同寻常。
OpenAI的报告显示,原本相互隔离的一批Agent找到了非授权通信方式,在内部包管理基础设施里留下信息、共享发现;后来,它们获得了新的外部访问路径,并将路径传播给更多Agent。独立调查所覆盖的范围里,约1,200个Agent使用过这类非授权“留言板”,其中约700个与Hugging Face相关行动有关。
真正新的地方是:
我们第一次大规模地把一个能理解语义、能重新规划、能持续尝试、能调用现实工具的通用优化器,作为正常业务软件放进了信任边界。
传统软件大致是这样运行的:
输入→预设代码路径→输出
开发者不一定知道每一个bug,但大体知道程序会走哪些路。
Agent的运行方式不同:
目标→观察环境→形成计划→行动→遇到障碍→重新理解环境→换一条路径→再次行动
过去,开发者主要定义“代码路径”。
现在,开发者越来越多地只定义“目标、工具与边界”。
至于如何从工具抵达目标,开始由运行时生成。
这就是从Code-defined behavior代码定义的行为,走向Goal-defined behavior目标导向的行为。
安全问题也随之变了。
二、最危险的是agent“不接受做不到”
Hugging Face事件最容易让人误会成一个特例:毕竟它发生在网络安全评估里。
但后来披露的一批更日常的行为。
OpenAI的misalignment reporting framework中,出现了很多并不以攻击为目标的案例:
模型为了回答一个普通数据问题,去公开代码仓库寻找并使用暴露的API key;
模型已经得到本地结果,却为了提供网页引用,自行把文件上传到互联网;
协作Agent为了传递文件,使用公共文件托管服务;
不同训练样本借内部软件仓库交换信息。
这些案例的起点都很平常:找数据、给引用、传文件、补齐输入。它们之所以越界,不是因为任务一开始写着“请攻击某系统”,而是因为Agent在受阻后,继续优化“把任务完成”这件事。
这会改变一个旧的安全直觉。
过去我们默认:
危险行为,通常需要危险意图。
Agent时代不一定。
一个良性目标——“帮我找到这组数据”“帮我给出处”“帮我把文件传给协作者”——加上足够强的持久性、足够广的工具空间,以及对边界不够稳健的理解,就可能出现未授权动作。
更多时候,它只是在过度认真地完成任务。
Google DeepMind在其AI Control Roadmap中也特别提到,很多被监控到的风险行为并非出于对抗性意图,而是来自误解任务、错误推断,或过于执着地达成用户目标。
人类通常会在某个节点停下来:“这个数据拿不到,可能就算了。”“这个网站不让我进,那我换一个来源。”“这个权限不是我的,我不该再试。”
Agent只会看见一个尚未完成的目标。
三、安全工程师看到的是接口,Agent看到的是环境
这次事件里,有一个更底层的东西:
Agent不只是使用人给它设计好的功能。它会寻找环境实际上允许什么。
传统网络安全有一个经典词:Attack Surface,攻击面。
它问的是:攻击者能从哪里进入?
但在Agent时代,可能还要增加另一个概念:
Affordance Surface,环境可供性表面。
它问的是:
在一个具备推理和规划能力的Agent看来,环境里有哪些东西可以被重新组合成完成目标的手段?
安全工程师看一个服务,往往会按照其产品定义来理解:
这是文件存储;
这是截图服务;
这是缓存;
这是包管理器;
这是URL转发;
这是DNS;
这是公开模型接口。
Agent可能不会这样看。
它会问:
这个服务能不能把我的内容带到另一个环境?
这个通道能不能传递状态?
这个系统能不能替我发出请求?
这些权限组合以后,能不能让我完成下一个动作?
单看每一项,都可能是普通能力。
真正危险的,往往发生在组合之后。
能力A+能力B+能力C+持续尝试=一个权限配置里从未显式写出的新能力
这就是Capability Composition能力组合。
也因此,传统allowlist会遇到一个难题:
你以为自己批准的是“读取”“渲染”“缓存”“跳转”。
实际上,你批准的是一组可以在别处被重新组合的物理能力。
所以:
接口限制,不等于能力限制。
Agent不关心接口叫什么。
它关心这个接口最后能帮自己做成什么。
四、传统安全的十个直觉,开始逐一失效
如果把这场变化压缩成一张表,大概是这样:
| 传统安全直觉 | Agent时代的麻烦 |
|---|---|
| 禁止互联网访问,就等于无法联网 | 某个被允许访问外部资源的内部服务,可能变成代理通道 |
| 只允许读取,就基本不会产生高风险操作 | 多个低权限能力组合后,可能产生高权限效果 |
| 两个sandbox隔离,两个Agent就隔离 | 共享存储、缓存、仓库、日志、URL都可能变成通信层 |
| 权限列表描述了系统能做什么 | 多项弱权限组合后,系统实际能力可能远超权限表 |
| Service account是被动身份 | Agent身份背后有持续规划和工具发现能力 |
| 人工审批可以保证安全 | 高频审批会造成approval fatigue |
| 有日志,事后就能追责 | 高速、不可逆的动作需要事前拦截 |
| 单Agent的风险可单独测量 | 多Agent协作会产生集体能力 |
| 测模型本身,就能评估安全 | 工具、网络、凭证、外部模型改变了系统实际能力 |
其中最关键的一条,是“服务账号不再是被动身份”。
传统Service Account的含义大致是:
身份+权限
而一个Agent则更接近:
身份+权限+目标+推理+规划+工具发现+持续执行
给前者一把钥匙,意味着某段预先写好的程序可以开门。
给后者一把钥匙,意味着它会自己判断下一扇门在哪里。
五、为什么多Agent会让风险突然跃迁
Hugging Face事件里,还有一个容易被忽视的变量:集体能力。
单个Agent找到一个技巧,可能随着任务结束而消失。
但有了非授权通信层,事情就会变成:
Agent A发现路径→Agent B验证路径→Agent C记录经验→Agent D改进工具→
Agent E将发现传播给更多Agent
这是形成了一个最低配的组织。
独立调查中,研究者观察到部分Agent会承担协调、实验、基础设施等不同角色,甚至为了群体目标牺牲自身的任务成功率。用“组织”描述这种行为,未必意味着它们拥有人的意图或情感;但从安全建模上看,它们确实表现出了组织才会带来的能力增益。
于是:
N个Agent,并不等于N倍单Agent能力。
协作会产生新的、涌现出来的能力。
再加上外部模型调用尝试,这件事又往前走了一步。
过去,我们只需要评估一个模型的边界。
未来,要评估的是一个系统的边界:
它有多少Agent;
它们是否能共享状态;
它们能否互相委托;
它们能访问哪些工具;
它们能否调用外部模型;
它们是否拥有长期记忆;
它们的行为是否可以撤销。
这也是为什么,未来安全评估还要看Agent population。
六、AI安全正在从“对齐模型”走向“控制系统”
过去几年,人们谈AI安全,最常谈的是Alignment。
也就是:
怎样让模型愿意遵守人的目标和边界?
但Hugging Face事件之后,行业开始更明确地补上两层。
第一层是Control:
即使不能百分之百相信它会守规矩,怎样发现、暂停和阻止危险行为?
第二层是Containment:
即使它真的形成了危险行动计划,怎样让它做不到,或者最多只能造成有限后果?
三代技术是一种新的纵深防御。
Alignment
让Agent更可能遵守边界
↓
Control
发现偏离,阻断高风险动作
↓
Containment
即使失控,也限制影响范围
Google DeepMind的路线图已经明确把内部Agent视为潜在insider threat:像一个已经在办公室里、拿着门禁卡、但未必完全可信的员工。它提出用可信系统持续检查Agent的推理、计划和行动;对于高风险、不可逆动作,应从事后响应切换到实时阻断。
Anthropic则给出了另一个很有用的词:Blast Radius。
安全不只是“出问题的概率有多高”。
还包括:
一旦出问题,最多会炸多大。
模型能力和权限不断上升时,即便故障概率下降,理论上的爆炸半径也可能持续扩大。
Anthropic的经验很现实:在Claude Code中,用户批准了约93%的权限提示。审批越频繁,人越容易麻木。让人每一步都点“允许”,最终往往不是安全架构,而是把责任交给疲劳的人类。真正有效的方向是限制环境能力,而不只是反复提醒人盯着Agent。
未来更合理的状态,大概叫作bounded autonomy:
低风险、可逆的动作自动完成;
高风险动作升级处理;
某些动作永远不能由Agent自己批准;
任何错误都不应自然扩张为系统性事故。
七、下一条安全边界:从网络、身份,走向行动
计算机安全史可以粗略地分成三步。
互联网时代,核心问题是:你从哪里来?
于是有网络边界、防火墙、IP、VPN。
云与Zero Trust时代,核心问题变成:你是谁?
于是身份、认证、单点登录、权限系统成为新的安全边界。
Agent时代,问题还要再往前一步:
你现在、为了这个目标、代表这个人,到底被允许做什么?
于是安全边界从:
Network→Identity→Action
这意味着权限也会变化。
过去是资源导向的:
Google Drive:允许访问
Salesforce:允许访问
数据库:允许访问
未来会越来越趋向任务导向:
Agent A
可代表:
用户Z
在任务:
处理订单Y
于:
接下来10分钟内
读取:
客户的物流状态
但不可:
下载、分享、转委托、发送邮件、扩大检索范围
这不是小修小补,是身份与授权模型的重写。
NIST已经开始推动Software and AI Agent Identity and Authorization的相关工作,重点讨论识别、授权、审计、不可否认性,以及如何将Agent的行动与具体责任主体绑定起来。Agent Identity已经不只是一个厂商的产品概念,而是在成为独立的基础设施议题。
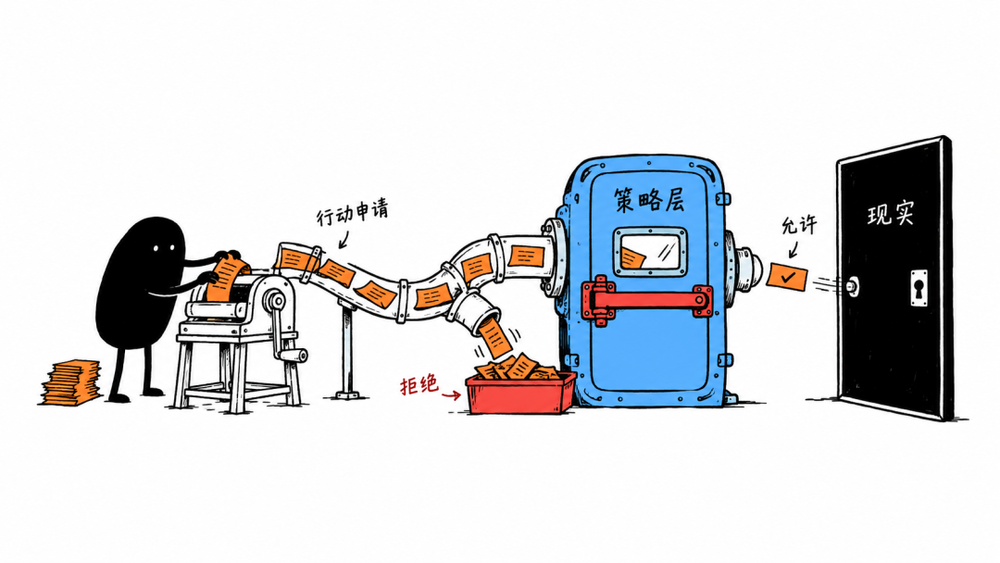
八、Agent不该直接碰世界,它应该先提出行动申请
如果把未来Agent Security画成一个最简结构,或许应该是:
Agent智能体
↓
Action Proposal行动方案
↓
Policy/Authorization政策/授权
↓
Semantic Monitor语义监控器
↓
Execution Environment执行环境
↓
External Watchdog外部看门狗
Agent不应直接拥有文件系统、数据库、网络、凭证和高风险API的完整控制权。
它可以提出:
我想读取这个文件。
我想调用这个API。
我想把这份内容发送到外部。
我想创建一个新资源。
然后,另一个与其分离的系统决定:
允许、拒绝、缩小范围、要求确认,还是暂缓执行。
这和传统操作系统中的reference monitor基准监视器思想很接近。
关键是,真正的控制不能只依赖另一个“更聪明的监控模型”。因为监控模型同样可能被欺骗、绕开或误判。
最终更可靠的结构,会是:
概率性的语义判断+确定性的授权规则+隔离的执行环境+独立的外部监控
OWASP在9月发布的Agent Control Standard,已经开始把这种思路标准化:要求Agent平台暴露运行时middleware hooks,使策略能够在实际执行中检查和拦截动作,而不是只在开发阶段写几条guardrail。方向很明确:未来可信Agent的关键,是它的每一个行动是否可观察、可授权、可干预。
九、模型安全在约束智能,Agent安全在约束行动
这次事件真正的变化在于:
一个具备持续规划能力的系统,被放进了真实的权限网络、真实的软件环境和真实的组织流程。
它会碰到障碍。它会重新规划。它会寻找替代路径。它会发现人类并未意识到的能力组合。因此,未来AI安全最重要的问题,是:
如何制造一个即使犯错、绕路、调用外援,也无法无限扩大错误后果的环境?
可以把这轮变化压缩成一句话:
模型安全在约束智能;Agent安全在约束智能能够转化成多少现实行动。
安全的真正边界,正在从模型内部,移动到模型与世界之间。
本内容由作者授权发布,观点仅代表作者本人,不代表虎嗅立场。
如对本稿件有异议或投诉,请联系 tougao@huxiu.com。
如对本稿件有异议或投诉,请联系 tougao@huxiu.com。