2026-10-12 10:22

速览
本文来自微信公众号: 瞰见Lab ,作者:瞰见·Ai
美国的AI公司指责中国厂商“抄袭”,转身又利用中国公开的技术给自己省钱,还继续向用户收费?海外博主的一张评论截图,把这个疑问摆到了人们面前。
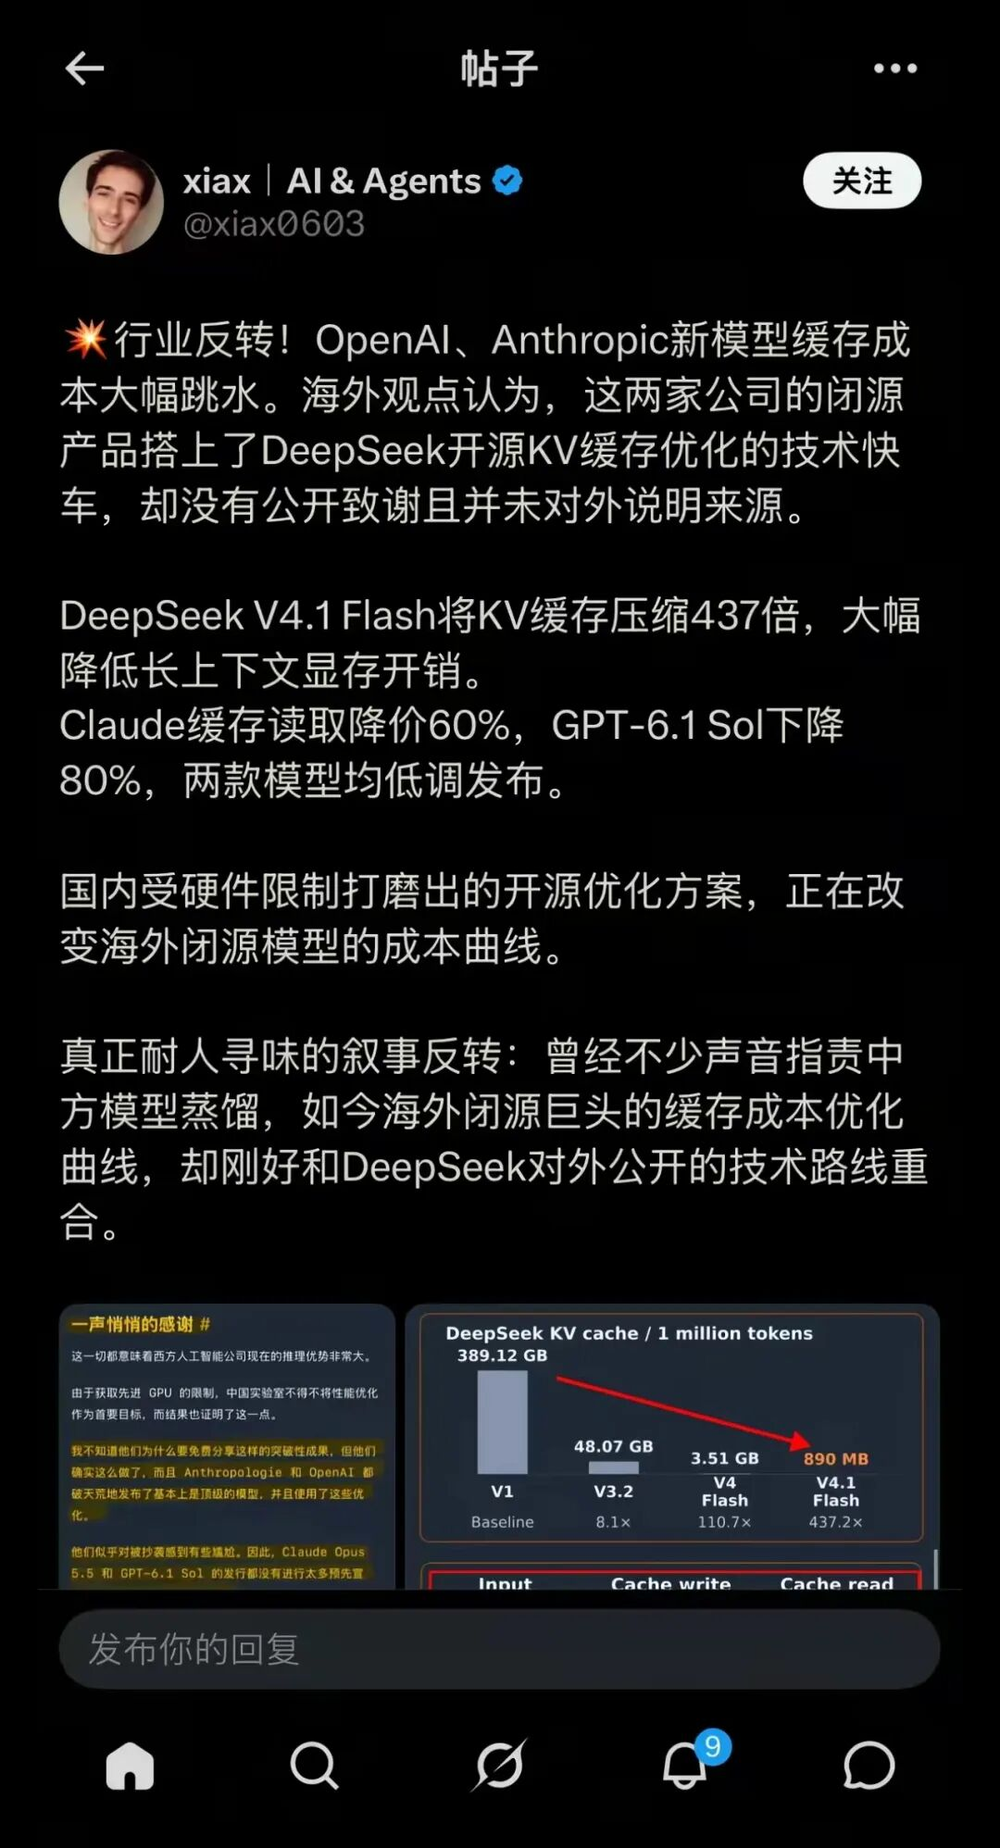
X用户xiax的评论截图。图中“使用了DeepSeek技术但是没有致谢”是原作者的质疑,下文会说明其中的证据缺口。
如果这是真的,场面就很难看了。自己创造的东西不可以碰,别人创造的东西可以使用,省下的钱算自己的本事,至于谁先想到这个方法,倒好像并不重要。
我核对了对应的英文原文、技术报告和价格说明。中国技术的进步有据可查,美国公司的降价也确实发生了。可从这两件事跳到“偷偷用不认账”,中间还缺少证据。
但顺着这些材料往下看,中国AI到底给世界带来了些什么?
本文看点
01
437倍的口径
02
降价与技术来源
03
明确采用的实例
01
KV CACHE
437倍,到底节省了些什么
先看截图里最醒目的数字。
9月17日发布的DeepSeek V4.1 Flash技术报告提到,缓存占用可以缩减大约437倍。但比较对象是早期的DeepSeek V1;和上一代V4 Flash相比,全局KV缓存占用的空间已经减少到了原来的四分之一左右。
在相同的上下文长度下,新模型每个token占用890个字节的全局KV缓存空间。按一百万Token计算,大约是八亿九千万字节(约890MB)。
该数字是有明确的数据来源的。它指的是全局KV缓存,不能把模型运行所需的全部显存都算进去,更不能理解为整个AI的成本降低了437倍。模型参数本身就需要占用存储空间,而计算也需要花费金钱。
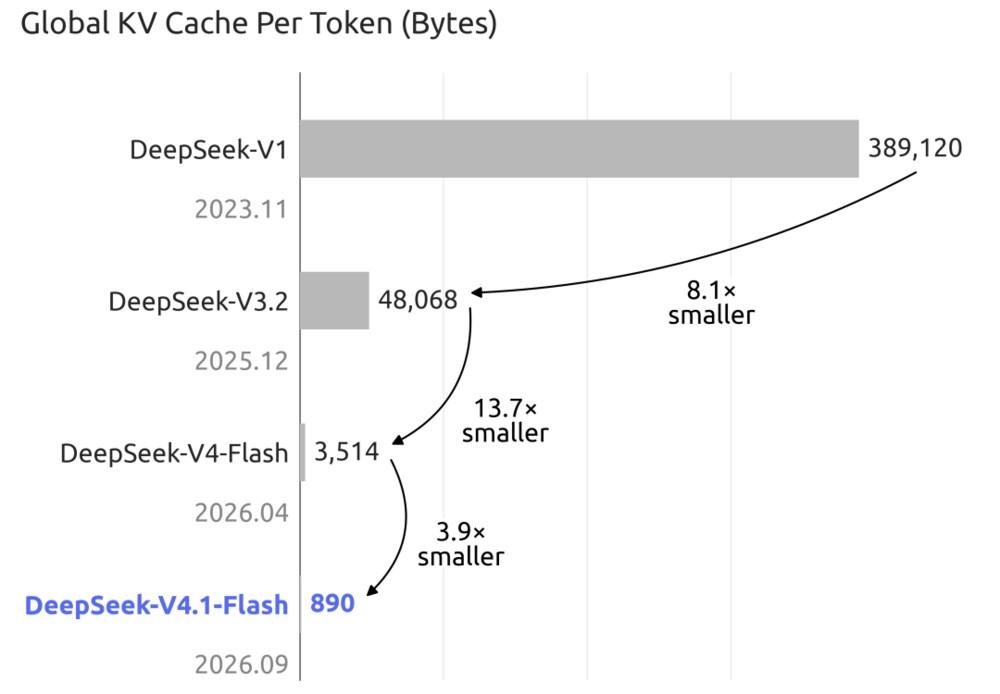
来源:DeepSeek V4.1 Flash技术报告图1(b)。比较的是每token全局KV缓存,不是全部显存或总成本。
不熟悉KV缓存,可以这样理解。模型分析文本时,会生成一些供后续运算使用的状态信息。把它们保存下来,在下一次使用时就可以直接调用了,避免了重复计算。内容越长,需要保存的信息也就越多。
让AI持续完成一个很长的编程任务,存储和搬运这些信息的成本就会很高。算得出来,并不代表可以存储下来;存下来了,还要看能不能传输、读取。
DeepSeek所做的就是把开支一点点降低下来。V4.1Flash采用了跨层缓存复用以及FP4缓存等方式,并且在报告中对存储于SSD或者主机内存里的持久缓存进行了单独分析。
这些技术不适合拿来做热闹的产品演示,却直接关系到AI能否以较低的成本完成长上下文任务。工程师所要的是这样的方法。
中国的团队把它做了出来,并且把技术路线也写出来了。这项贡献本身就很厉害,不需要再加上一份外国公司“忏悔书”来增添气氛。
02
CACHE PRICE
账单便宜了,就能证明用的是谁的技术吗?
英文文章题为《The AI Race Just Got Awkward》,意思是AI竞赛突然变得尴尬了。
作者认为OpenAI、Anthropic新模型的价格下降,是因为两家借用了DeepSeek的缓存优化技术,但是没有进行解释。
这些降价数字是能查到的。
Claude Opus 5.5的缓存读取费用由原来的Opus 5每百万token 0.50美元降低到现在的0.20美元,下降了60%。Anthropic发布的公告里已经把账单给列出来了。
GPT-6.1 Sol的缓存输入的价格为每百万tokens 0.1美元。英文作者拿它与两个月前GPT-5.6 Sol的0.5美元比较,得出降幅80%。但按目前GPT-5.6 Sol的0.4美元计算,降幅就是75%;而和GPT-6 Sol的0.2美元相比,降幅就变成了50%。
这组数据说的是API缓存读取价格,降幅要连着比较基准一起看。换一个基准,百分比就不一样了。
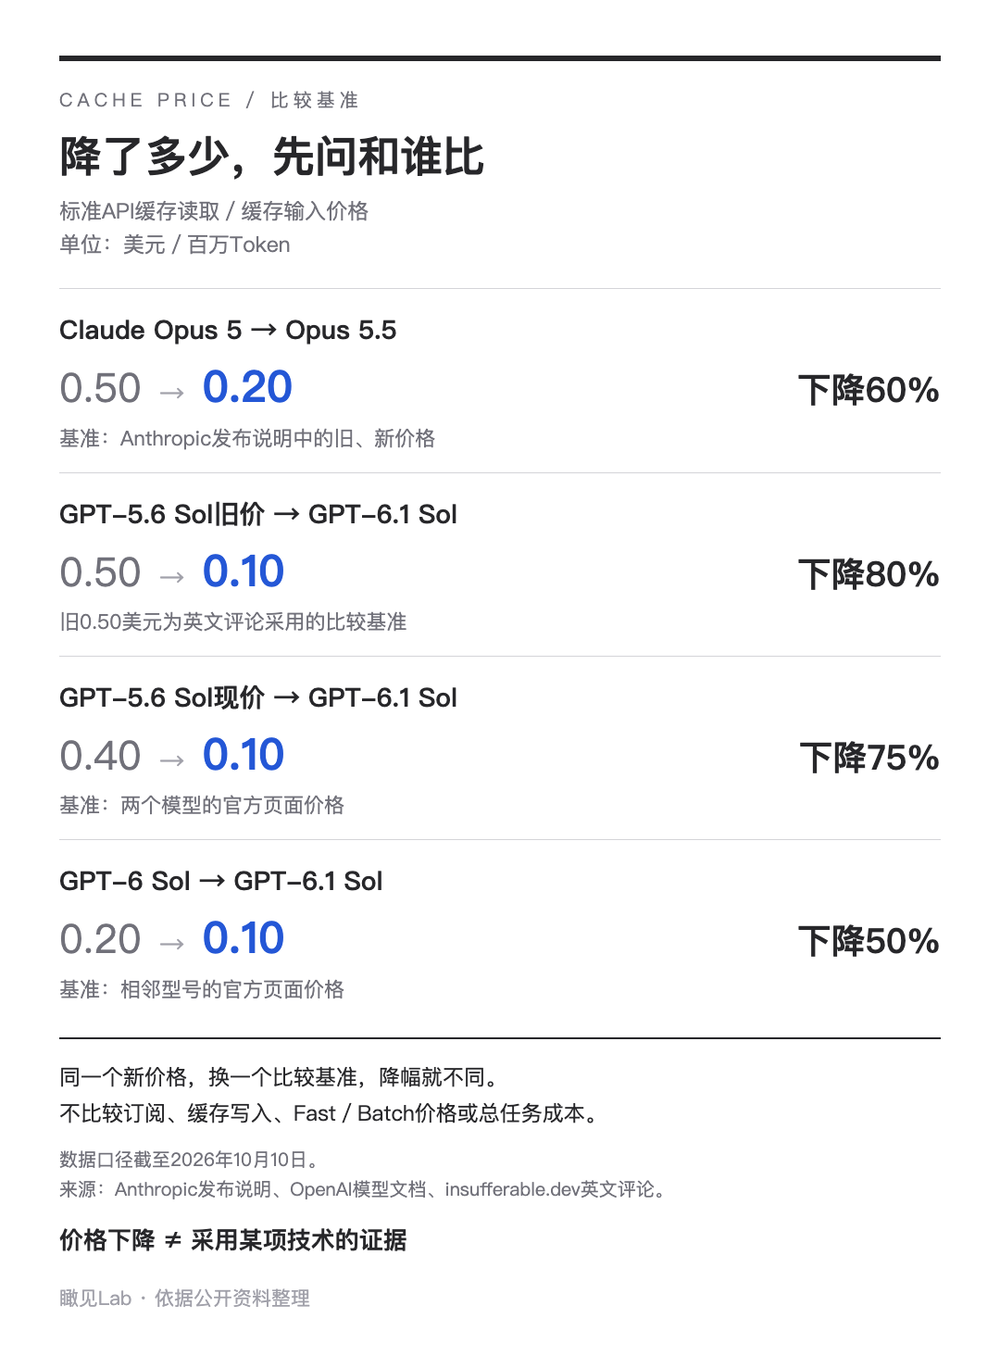
瞰见Lab依据Anthropic发布说明、OpenAI模型文档及英文评论整理。单位为美元/百万Token,标准API缓存读取或缓存输入价格;口径截至2026年10月10日。
接下来要问的是,两家公司有没有公布采用DeepSeek架构的信息?有没有工程师提供相关代码和解释?
这篇英文评论没有给出。作者把缓存读取降价当作采用了这项技术的依据。
这个推论太快了。厂商要向顾客收取多少费用,会受到产品的定位以及竞争对手等因素的影响;至于实际成本怎么降下来,可能涉及多种工程改良。一张价格表并不能说明技术来源是什么。
Opus 5.5有正式发布的说明,GPT-6.1 Sol也有官方更新记录。“发布低调”也不能说明公司用了别人的成果而心虚。
可以质疑,但是不能把想听的答案事先塞给对方。
接下来的材料是不用推测的。
03
OPEN RESEARCH
英伟达也把出处写明了
英伟达把FP8训练方案也列入了Nemotron Nano 2技术报告的一节里。
这一节开头就指出,整个预训练过程中使用的是DeepSeek的FP8训练方式。
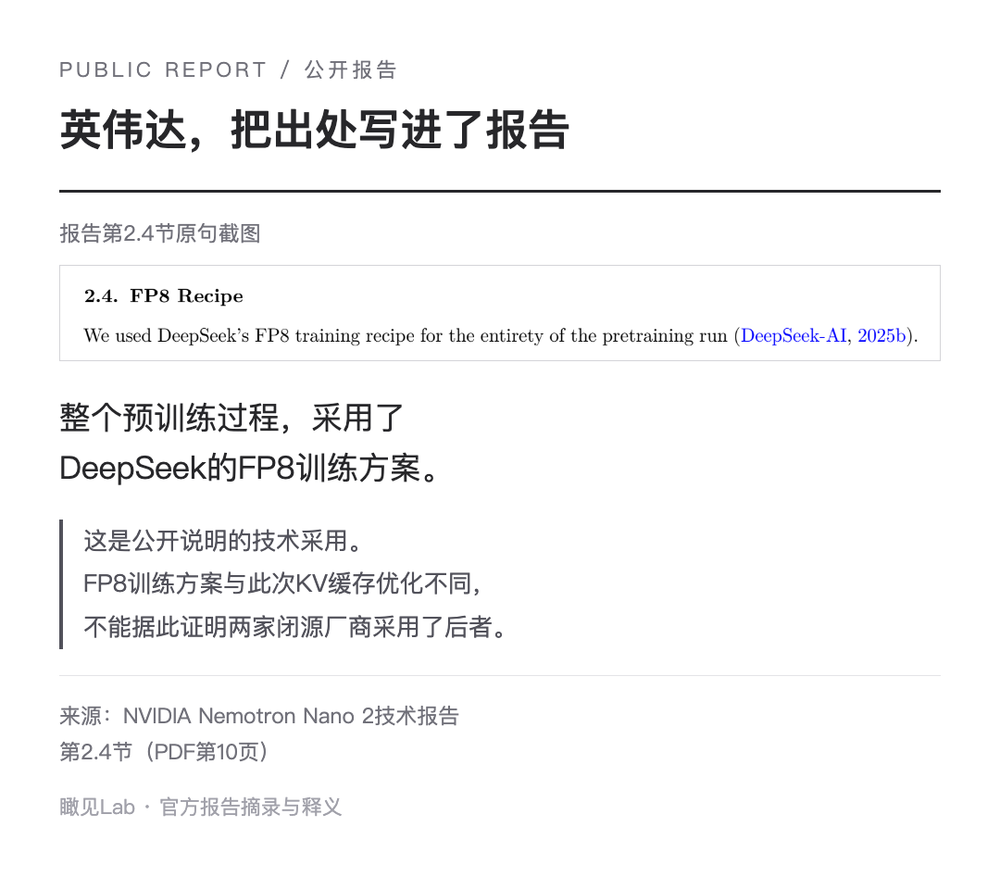
来源:NVIDIA Nemotron Nano 2技术报告,第2.4节原句截图。这里说的是FP8训练方案,与此次KV缓存优化并非同一项技术。
后面还写明了具体细节。权重按照128×128的块来进行量化,激活则采用1×128的方式;哪一部分使用了DeepSeek的方法、哪一部分做了修改,在报告中都有所提及。
这里所用到的方法是训练方案,并不是本次讨论的KV缓存优化的内容。Nemotron也发布了模型权重,但是不能用来证明OpenAI或者Anthropic的封闭模型使用了哪些内容。
但它至少证明了一件事。美国一家重要的AI公司用上了中国团队公开的技术成果,并在自己的报告里说明了出处。
一个中国的团队提出了解决方案,另外一个团队去实施并且做了一些改进,然后说出了出处。这就是技术交流可以产生实际效果的地方。
用开源成果赚钱,本身算不上什么丑闻。开放使用范围要根据具体的许可证来决定,引用公开的方法与涉嫌违规获取模型输出是不一样的。中国的成就应当得到认可,美国公司合理的利益也应该受到保护。
英伟达愿意说明技术来源,这是值得赞扬的。技术交流越是充分,就越是应该交代清楚研究人员做了哪些事情。
评价中国AI时,我们也该问问,中国的工程师给这个行业带来了多少新的东西?
04
ORIGINAL CONTRIBUTIONS
中国AI的发展,不能一直只有“向谁学习”的问题
今年2月份,Anthropic就指控了DeepSeek、Moonshot以及MiniMax这些公司有违规获取Claude能力的行为。它说这些行为涉及到大量的虚假账号,并且违反了服务条款和地域限制。这是Anthropic一方的指控。
它也在同一篇文章中承认,蒸馏是普遍采用的正常训练手段,美国领先的实验室也会蒸馏自己的模型。
所以,每项争议都得具体讨论。有无违规获取数据、证据是什么、应承担什么样的责任等都要分头说明。
令我反感的是,在对中国人工智能的讨论中,这样的指责很容易占据大部分的空间。谈论技术突破时,首先就要弄清楚是否是从美国那里学到的;提出工程方案之后,又有不少人认为减少成本不算很大的创新。
这样评价,对真正做事的人很不公平。
Anthropic的文章更是把中国厂商看上去迅速发展的表现,与获取美国模型能力联系在一起,并以此来支持对先进芯片进行限制。按它的说法,中国AI的发展很大程度上依靠于从美国模型中得到的能力。
这个观点是可以争论的,并且也应当被验证。一家公司提出的违规指控,并不能代替对中国团队各项技术成果的判断。DeepSeek怎么压缩缓存、用什么精度训练、其他人为什么愿意学,这些都有材料可查。
以前讨论人工智能的时候,人们总是关注着哪个公司的模型最先达到最好的效果。也该看看谁能降低长期使用的成本。一项能力是只有少数大公司负担得起,还是更多团队都能部署,真正能够发挥作用的范围相差很大。
对于需要多次处理大量数据的小型团队来说,价格和部署要求,直接影响他们能不能用上这个系统、能用多久。工程师将缓存减小了,并且把训练方案公布出来,改变的就是上面所提到的那些条件。
中国团队已经拿出了一些别人愿意用的新方法。讨论时只剩下是否抄袭,那就太懒而且很傲慢。
至于开源团队为什么选择公开,当然也可以继续追问。他们需要投入研究的成本,并且也可能使得竞争对手获益;公开之后能否被广泛采用并得到改进、能否给团队带来商业收益,都值得关注。
一家公司用了公开技术,继续收费,这本身没有什么可指责的。值得我们警惕的是,在享用着全世界的研究成果的时候,却按照国别来决定是否承认他人的原创性工作。如果有证据表明存在双重标准,我们当然可以毫无保留地指出来。
中国团队已经做出了哪些贡献?既能看技术报告,也能看采用这些技术的团队怎么说。相比一张情绪很足、证据却不完整的截图,这些材料更加能够经受住追问。
以后再有人轻易断言中国AI只是在模仿美国,请先看一下上面的内容。
不能讨论中国公司时,只查它从别人那里拿走了什么;等别人用上中国技术,又觉得这没什么好说的。
END
本文写作说明
本文以一张社交媒体截图和英文评论为切入点,通过DeepSeek的技术报告、厂商的价格说明和英伟达的报告来展开分析。文章没有采访公司人员,不能把缓存降价当作使用了某种技术的证据。截图中的指控仍然归于原作者,技术和商业上的评价则要分别对待。
主要的数据来源
数据来源于DeepSeek发布的公开技术报告、OpenAI官方模型的价格和更新记录、Anthropic发布的说明和蒸馏声明、英伟达Nemotron Nano 2的技术报告以及insufferable.dev最初的评论文章。
本内容由作者授权发布,观点仅代表作者本人,不代表虎嗅立场。
如对本稿件有异议或投诉,请联系 tougao@huxiu.com。
如对本稿件有异议或投诉,请联系 tougao@huxiu.com。