2026-10-22 12:53
速览
本文来自微信公众号: 字母榜 ,作者:苗正
这几天,全网都在找一个人:陈广宇。
起因是有传闻说,他拿到了年薪100万美金的offer。这个数字在硅谷不算天花板,一个资深工程师加上股票,拿到这个数不稀奇。但他今年才17岁。
就算不谈年薪,一个17岁的少年,被硅谷各家公司抢着要,这件事本身就够魔幻了。
接下来,他的去向传闻一个接一个。有人说去Anthropic了,不过后来这条消息被陈广宇本人否认。
随后又有人说他去卡内基梅隆继续进修了,还有人说他加入了谷歌元老杰夫·迪恩(Jeff Dean)创办的Discovery Loop,方向是用AI去自动化科学研究。
但最重要的是,上到AI大厂下到AI圈VC,到底为什么大家都在找他?
10月15日,陈广宇在社交媒体上发帖,宣布离开月之暗面。他说,在这里度过的一年,是“迄今为止最美好的时光”。
帖子下面,Anthropic研究员肖尔托·道格拉斯(Sholto Douglas)留言,先是祝贺,然后问他“去卡内基梅隆的计划还一样吗”,并邀请他去旧金山一起工作。

陈广宇的回复是:“谢谢肖尔托!我正要去湾区。”
既然Anthropic的研究员发出了邀请,外界自然猜他会加入Anthropic。于是一段时间内,社交媒体疯传“陈广宇在离开月之暗面24小时内加入了Anthropic”。
但10月16日,有人在评论区直接问他:是不是加入Anthropic?他的回答只有一个词:“No”。这条传闻就这样被他本人否认了。
10月20日,一个专门追踪硅谷AI人才流动的匿名账号Arfur Grok发帖称,陈广宇加入了Discovery Loop。
Discovery Loop成立于今年8月,由杰夫、桑杰·格马沃特(Sanjay Ghemawat)、郭·勒(Quoc Le)和奥里奥尔·维尼亚尔斯(Oriol Vinyals)四位前谷歌核心研究者共同创办。
其中,杰夫曾是谷歌首席科学家,参与领导了Gemini的研发;维尼亚尔斯也是Gemini的重要技术负责人。
这家公司想做的事,用大白话讲就是让AI自己做科研。AI先提出假设,再设计并运行实验,分析结果,然后根据反馈开展下一轮研究,一圈一圈循环下去。Discovery Loop(探索循环),名字就是这个意思。
这家公司的首轮融资由Radical Ventures和Khosla Ventures领投,谷歌母公司Alphabet也参与了投资。另据外媒报道,Discovery Loop至今还没有发布任何产品,却已经在寻求约500亿美元的估值。
Discovery Loop表示不对人事问题置评,陈广宇也没有回应。
同时陈广宇本来也有回卡内基梅隆继续读书的计划,此前肖尔托那句“卡内基梅隆的计划还一样吗”指的就是这个。
陈广宇的简历显示,他在今年八、九月份时,曾在卡内基梅隆学习过大约一个月。
Menlo Ventures的投资人迪迪·达斯(Deedy Das)表示,有个17岁的少年拿到了5份百万美元级别的offer,但他没有点名。此外他还表示,这个少年飞越半个地球去美国前十的大学读本科,两周后辍学。
因此网友推测,此人可能指的就是陈广宇。
但是这里要明确一点,卡内基梅隆大学的主校区在美国东部宾夕法尼亚州的匹兹堡,离湾区大约4000公里,横跨整个美国。
在湾区有一个小的分校区,在硅谷的山景城(Mountain View,NASA Ames研究园区内)。然而这个分校区规模很小,主要做硕士项目和部分产学研合作。卡内基梅隆最核心的计算机学院(SCS)就在匹兹堡。
所以陈广宇去湾区大概率不是为了上学。
不过其实还有一条线,湾区和陈广宇的交集不止Discovery Loop,还有Tilde Research。
Tilde Research是帕洛阿尔托的一家机制可解释性(mechanistic interpretability)实验室,2024年7月成立,11月公开亮相,口号是“理解智能”。
Tilde Research专攻模型内部机理、新架构和预训练科学。2025年年中它完成800万美元种子轮。
陈广宇和Tilde Research之间可以说是“缘,妙不可言”。
据陈广宇自己描述,他曾经在社交媒体上发表了一篇文章,当时他只有20个粉丝,被DeltaNet关键贡献者、MIT在读博士、线性注意力开源社区FLA发起者杨松琳回复,帖子由此扩散。Tilde Research的本·凯格温(Ben Keigwin)也因此注意到了陈广宇,并主动约他通话介绍项目。
2025年7月,陈广宇独自前往加州帕罗奥图(Palo Alto),在Tilde Research开始为期七周的实习。
所以学界也有人猜测,陈广宇是想回到Tilde Research,去继续此前的研究工作。
说了这么多,仍然有一个重要的问题没说:一个17岁的少年,凭啥能让这么多大厂和投资人追着跑?
3月16日,陈广宇作为共同第一作者的《Attention Residuals》(注意力残差)技术报告在社交媒体上被马斯克本人点赞。
马斯克评价这篇报告说:“月之暗面干的事真是让人印象深刻!”
事实上,这只是陈广宇的高光时刻之一而已。
陈广宇所处的地段,是整个行业最缺人的位置。
打个比方,一个大模型就像一家大餐厅。架构,相当于菜单怎么设计;优化器,相当于厨师怎么根据反馈不断改进手艺;而GPU kernel(GPU内核),则是后厨灶台上的具体操作,比如火开多大、锅怎么颠、食材怎么摆。
同样一道菜,只要后厨下功夫,哪怕是同样的设备,一晚上也能多做出好几倍的菜。
陈广宇的特别之处在于,这三层他都碰过。
2025年5月,他写了怎么用Triton实现矩阵乘法并做L2缓存优化,同月还写了如何推导并实现一个核范数约束下的优化器。
7月,他用TileLang实现Flash Attention,相关论文称比FlashAttention-2快1.3倍,随后参与了MoMoE。
9月,他连写两篇Triton讲解。
10月,他又写了Gram-Space Manifold Muon,也是一篇优化器的文章。
从底层的GPU代码,到中间的优化器,再到顶层的模型架构,当时只有16岁的陈广宇,一个人走完了别人一辈子都不一定能走完的路。
他在自己的主页上也写得很直白:他关心的是“高效的、与硬件对齐的算法和内核”,还特意标注了一句“co-design them!”(把它们一起设计)。
这是一个刚诞生没多久的赛道,没有任何的“经验”可谈。
BigGo Finance的分析提到,在大模型时代,底层算子优化、注意力机制的数学推导这类前沿领域,没有现成的教科书可抄,全世界最聪明的人其实站在同一条起跑线上。
最关键的一点是,陈广宇是真的“懂了”。
陈广宇有一篇文章,标题是《Triton Flash Attention Kernel Walkthrough:The Forward Pass》(Triton Flash Attention内核逐行讲解)。
开头陈广宇就说,我不打算讲基础语法,官方文档已经讲得很好了,这篇要讲的是“为什么”(This is about understanding the why)。
文章里有这么个细节,陈广宇的代码把循环拆成了两段。
对于此,他的解释是,因为掩码操作tl.where很慢,如果每一块都用一遍,会拖慢速度。拆成“对角线之外”和“对角线上”两段,只在必要的地方用。
还是用厨房来举例子,原材料在上砧板之前要检查,以前的规矩是不管原材料如何,都需要检查一遍。但现实是99%的原材料根本不需要检查,因为这些原材料在放进去之前就已经检查过了,只有那些容易腐烂和损坏的原材料才需要检查。
陈广宇的做法就相当于只检查那1%容易坏的,其他99%都直接通过。变相提升了100倍的效率。
除此之外,陈广宇还是一个非常会学习的人,成长速度惊人。陈广宇曾在2025年9月时表示,他接触Transformer并没有多久。第一次认真接触科研时,陈广宇称自己什么都不懂,不知道Transformer是什么,也看不懂机器学习论文。
现如今,陈广宇已然成为行业里的大拿。
这里面的主要原因,是他的学习方法也很特别。陈广宇表示,他从一篇经典论文开始,每天花几个小时和Gemini对话。遇到看不懂的地方截图发给它,让它解释,再反过来向它提问。
同时陈广宇还会去读GitHub、博客、研究者的个人主页,琢磨他们的“研究品味”。他不走传统的学习路线,一门一门地学,陈广宇认为那样太慢了。
当然,AI也不是万能的。遇到重大选择时,陈广宇会去请教DeepSeek研究员袁境阳。陈广宇自己总结说,网络很重要。即使你再有信心,也能从前辈那里学到很多经验。
陈广宇在Codeforces(编程竞赛平台)上有2000分以上的评分,属于前3%左右。说明他是有编程底子在的。
陈广宇宣布离职后,当年拍板招他的月之暗面研究员杜雨伦,在他的离职帖下评论,说自己和陈广宇就这个决定“有过几次长谈”。
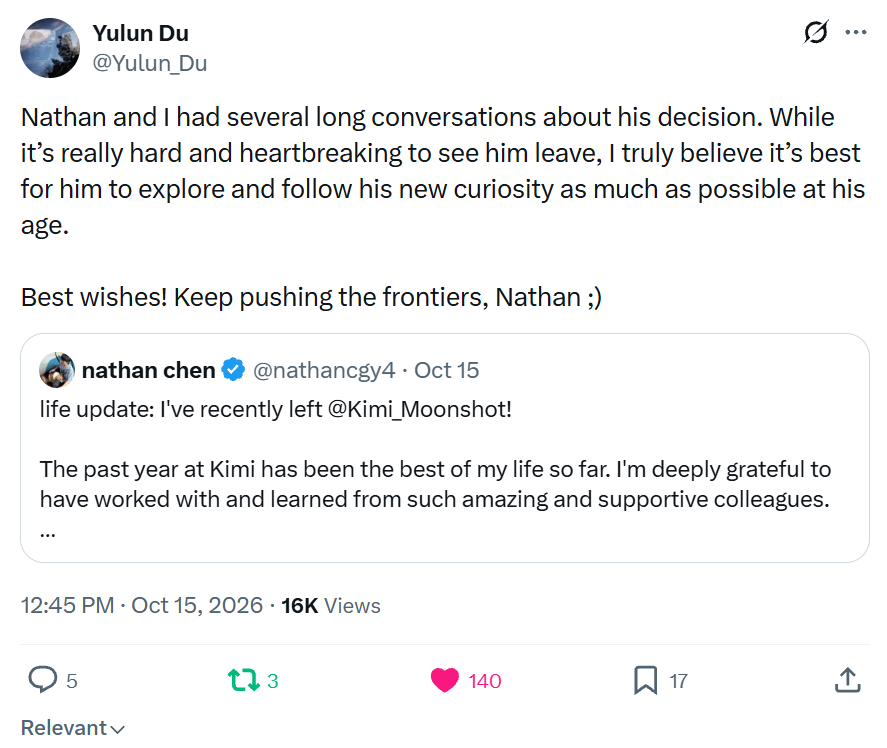
他还说,看到陈广宇离开,自己“难过、心碎”,但在这个年纪,尽可能去探索、追随新的好奇心,可能是更好的选择。
这里还有个小细节,杜雨伦其实也毕业于卡内基梅隆。
离职难免都会有些不舍,但也会为公司留下什么。比如DeepSeek的郭达雅,今年年初离职以后,他曾经发表过的GRPO算法被DeepSeek沿用至今。DeepSeek的V4.1 Flash技术报告中就曾提到,后训的第一步,就是采用了监督微调(SFT)和基于GRPO的强化学习,分别训练各领域的专家模型。
那么陈广宇给月之暗面究竟留下了什么呢?
陈广宇在月之暗面只待了不到一年,从2025年11月作为16岁的实习生加入,到2026年10月离开。但他留下的东西,已经深入Kimi最核心的位置。
2026年7月,Kimi K3发布,总参数2.8万亿。月之暗面称它是全球首个开放权重的3万亿级别模型。
K3发布当天,在Artificial Analysis的智能指数上,K3得分57,排名第三,仅次于Claude Fable 5和GPT-5.6 Sol,超过了Claude Opus 4.8。
前文提到的Attention Residuals,就是K3的底层技术之一。
陈广宇还参与了月之暗面KDA(Kimi Delta Attention)的计算内核加速,在离职帖里他写到,自己和张宇一起优化了它的内核,并探索了各种可能的设计。
不过就在陈广宇离开月之暗面前后,K3.1的消息开始密集出现。
9月底,月之暗面开放平台后台的注册表里,出现了“kimi-k3-1”的字样。
10月10日,开放平台出现预告页:100万token上下文、Low/High/Max三档推理、Agent、Swarm多智能体能力。野村证券称,“K3.1将会在10月中旬前发布”。
10月17日前后,官网前端再次出现“k3d1-agent”,并发现了新的bot模块,官网的模型指纹也被指有变化。
从目前的蛛丝马迹看,K3.1更像是K3的增强版,偏Agent和长任务,并没有更换架构。
所以,就算陈广宇离开了,他对月之暗面的贡献依然在那里摆着。
人会走,技术留下。
本内容由作者授权发布,观点仅代表作者本人,不代表虎嗅立场。
如对本稿件有异议或投诉,请联系 tougao@huxiu.com。
如对本稿件有异议或投诉,请联系 tougao@huxiu.com。