2026-10-26 19:16
速览
本文来自微信公众号:腾讯研究院,作者:王焕超(腾讯研究院高级研究员),题图来自:AI生成
1882 年初,三十七岁的弗里德里希·尼采,买了一台时髦的机器。
那台机器叫“马林-汉森书写球”,由一位丹麦牧师专为盲人设计,五十二个键呈半球形排布,像一只钢制的刺猬。
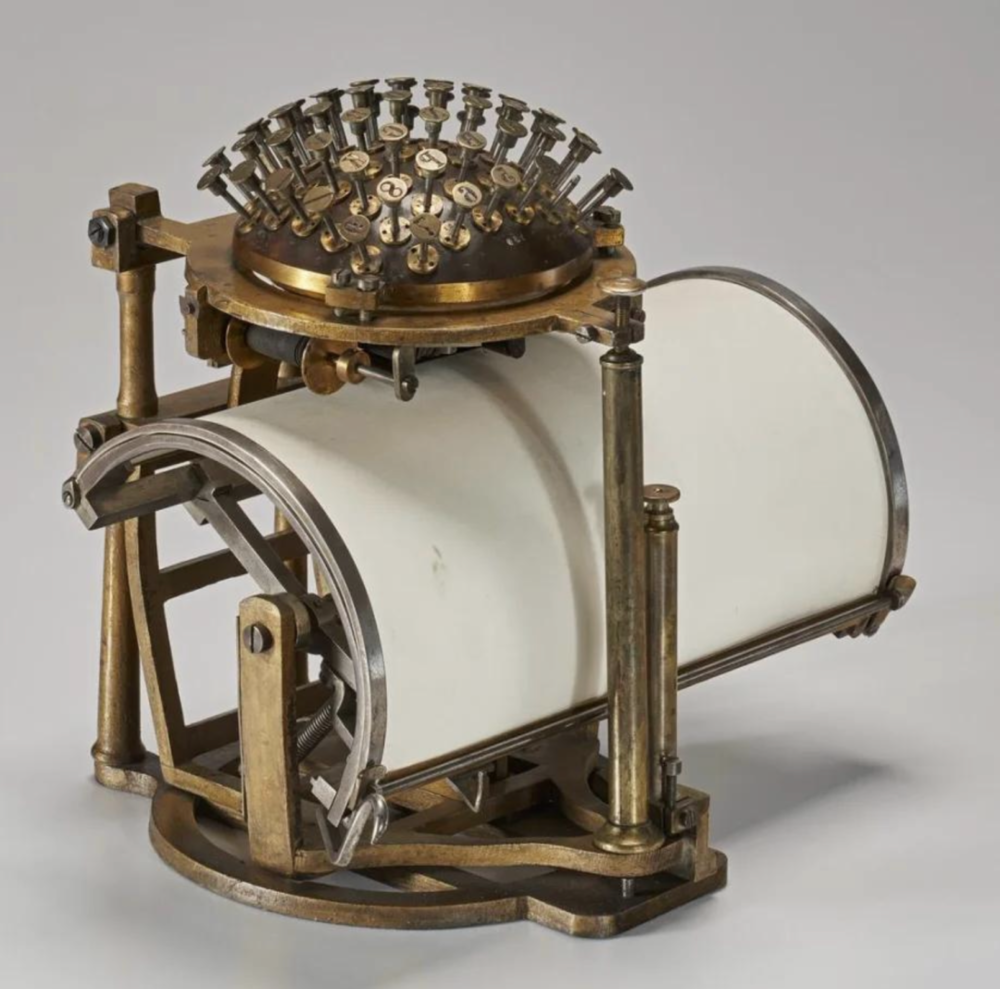
大概是这个样子
当然,尼采买它并不是为了追赶时髦,而是因为他的眼睛快不行了。长时间盯着纸面会让他头痛欲裂,几乎无法再完成长时间的手写。他必须找到一种不那么依赖视力的写作方式。
在使用了一段时间书写球后,他的朋友,作曲家海因里希·科塞利茨在信中说,“也许借助这件新工具,你会获得一种新的表达方式”,他自己在音乐和语言上的思想,就常常取决于笔和纸的质量。
尼采承认了。他在回信中的一句话,后来被反复引用:
“你说得对,我们的书写工具,也参与了我们思想的形成。”
后世研究者注意到,尼采用书写球打出的文字,比他本就以格言见长的文风更加紧凑,原先那些一路盘旋、层层从句的长句消失了,取而代之的是更多的短句,近乎电报。
一个世纪后,德国媒介理论家基特勒在《留声机、电影、打字机》(1986)中,把这段往事,提拔为他媒介理论的关键证词。在基特勒看来,尼采的病眼,亦是一种隐喻。写作者并非先有思想,再挑一件顺手的工具去表达。恰恰相反,是工具先划定了一片可以被思考的区域,思想再在这片区域中生发出形状。换一件工具,就换了一种思考的方式。
我想从这里开始谈 AI 写作。
今时今日,关于 AI 写作的绝大部分讨论,都停留在同一个维度上:用,还是不用。用了是不是作弊,用了还算不算你写的,用了要不要声明。这些问题都成立,但它们共享一个可疑的预设,即我们正站在一个岔路口,手里仍握着选择权。
而我的判断是,这个岔路口并不存在。AI 写作并非是一个选项,它是一种命运。
当然,“命运”在这里并非文学修饰,也不是宿命论式的投降。它更接近海德格尔所说的“被抛”:你不是在若干可能性中挑了一个,而是你一睁眼,就已经被抛在某种处境里了。
尼采自然可以不买那台写作球,代价是不再写作。这就叫命运。你看似有所选择,但其实所有的选项,都在同一侧。
命运的谱系
将视野投诸媒介工具发展史,你会发现,对新恐惧的抵抗,是一种循环。
开端,在柏拉图的《斐徳罗篇》里。苏格拉底讲述了一个埃及故事,神明塞乌斯发明了文字,并把它献给国王塔穆斯,说这是一剂能让埃及人更有智慧、记忆力更强的良药。塔穆斯拒绝了。他说,文字不会带来记忆(mnemé),只会带来提醒(hypomnesis)。人们将因为信任外部的符号,而不再从内部唤起知识。他们看上去博学,其实只是“看上去”。
这是人类第一次完整地表述认知外包的恐惧。从后续来看,不能否认它的精准。
此后的名单,可以一路排下去。印刷术被指控让人“只读不想”,打字机被海德格尔批判“把书写从手的本质领域剥夺出去”,让文字从存在的痕迹,降格为通讯的手段。文字处理器被批评家抱怨消灭了修改的痕迹。至于互联网,更是众矢之的。如尼古拉斯·卡尔在《浅薄》里忧虑道,它会让我们失去深度阅读与思维的连贯性。
每一次媒介更替,新工具面世,都会掀起一波恐惧和批判的浪潮。
但值得注意的是,在技术外包的历史上,似乎只有认知外包会引发伦理批判,但物理外包很少。没有人想着批评起重机、蒸汽机、洗衣机,偶有卢德分子之流,也迅速被淹没在历史洪流中。但每一次外包触及到我们的头脑,触及到“想”,记忆、书写、检索、表达,警报都会准时响起,批判如影随形。大概因为,物理外包只动用肌肉,延伸肉体,而认知外包则事关“我是谁”。
AI 显然处在这个恐惧谱系的延长线上。
但这一次的恐惧,确实有一点新的内涵。以往所有的认知外包,仍停留在外部存储层面,文字实现记忆功能,印刷实现传播功能,搜索引擎仅用于检索,文字处理器是帮你修改。最终,写作最难的一步,也是最核心的工作,也就是把混乱的意图压缩成一个句子,把网状的想法压缩成线性的文字,仍需要人来完成。但生成式 AI 是第一次,让这个压缩动作本身,被外包了。
所以这一次的恐慌有其正当性。它不正当的地方,在于恐惧的方向。大部分人都还在纠结,“我该不该让它替我写”,而真正已经发生的事情是,哪怕不直接让它生成、输出,但你赖以写作的所有元素,都已经被 AI 偷梁换柱了。因而我称之为命运。
没有外部
一个基础的经济学原理是,当一项工具把某个环节的成本推向零,不使用它的人,就要独自承担成本差。
当然,成本差是可以用意志来填补的。类似于今天仍有作家坚持手写初稿,仍有摄影师只拍胶片,他们付出了更多的时间和金钱,换来一种自己认可的工作方式。只要代价能够承担,退出就是有可能的。如果 AI 写作的不可退出性仅止于此,那它就只是一道选择题,算不上命运。
1970 年,经济学家阿尔伯特·赫希曼在《退出、呼吁与忠诚》中,给“退出”下过一个朴素的定义:顾客不满意一家企业,就转身去买另一家的产品。但这个定义,有一个前提,也就是退出必须有一个可以退往的地方。只有存在一个外部,退出才成立,才有意义。
现在的问题在于,那个可以退往的外部,正在一层一层地消失。没有外部了。每个人都置身事内,无法退出。
2025 年 7 月,德国图宾根大学 Dmitry Kobak 团队在《Science Advances》发表研究。他们比对了 2010 至 2024 年超过 1500 万篇 PubMed 论文摘要,寻找那些在 2024 年突然大幅超过历史趋势的“过量词汇”(excess vocabulary)。结果发现,真正暴涨的是一批风格词,类似于 delves(深入探讨)、showcasing(展现)、underscores(凸显)等等。
作为对比,过去十几年里,在增长的往往是内容词,比如“埃博拉”“新冠”,它们对应的是现实世界里发生的事,而 2024 年,暴涨的几乎都是动词和形容词,对应的只是一种说话的方式。基于这些痕迹,研究者给出的下限估计是 2024 年的生物医学论文摘要中,至少 13.5% 经过了大语言模型的加工。
这个数字的重点在于它的表现形式。AI 对于写作的改造,最先被大规模测量到的后果,并非内容造假、内容注水、AI 泔水这些,而是风格趋同,它让越来越多的人,开始用同一批词说话。
2025 年 6 月,麻省理工学院媒体实验室的 Nataliya Kosmyna 团队发布了一项脑电实验,让 54 名被试分三组完成议论文写作,分别是纯脑力组、搜索引擎组、大模型组。研究者对三组文章做了命名实体与 n-gram 分析,结论是,大模型组的文章在主题与措辞上高度收敛。同一个题目,纯脑力组会给出各式各样的角度,而大模型组给出的,只是同一篇文章的若干变体。
另外两个结果同样值得注意。一是大模型组的脑区神经连接强度最弱,二是在写完文章之后不久,大模型组中有 83% 的人,无法准确引用自己刚刚“写”出来的句子。研究者把这种状态,命名为“认知负债”(cognitive debt)。
这些彼此相似的文字,甚至连它们名义上的作者都记不住。而它们正源源不断地流入公共空间。
即便你一个字都不让 AI 碰,你的读者、你的编辑、你的评审人、你的招聘方,每天都在阅读大量 AI 参与生产的文字。他们对什么叫“通顺”“结构清晰”“合格的开头”“动人的表达”的判断标准,正在被这些文字重设。
当越来越多人的文字向同一个中位数收敛,那么,这个中位数就成了新的标准。标准一旦成立,偏离它的写法就会被当做“不够通顺”“不够规整”。坚持不用的人,就不止是“异类”,而可能直接被判为不合格。
更关键的是,你本身就处在这个文化生态之中,当生态中的一切都在围着这个标准变化,每天耳濡目染、大量吸收的你,又有什么底气说自己没有被改变呢?
这已经不只是一个修辞上的反问。2024 年,德国马克斯·普朗克人类发展研究所的 Hiromu Yakura、伊亚德·拉赫万等人,分析了 ChatGPT 发布前后超过 36 万场 YouTube 学术演讲与 77 万期播客节目。这是浩大的工程量,他们处理了累计 74 万小时的口语材料,只为了分析那些被识别为 ChatGPT 偏好的词汇,会不会进入人类的口头表达。
答案是会。ChatGPT 发布之后,delve、meticulous、comprehend、swift、boast 这些词,在人们的口语里出现得明显更多了。
这项研究最大的意义,在于它选择的材料。要知道,学术论文还有可能交给模型润色,但即兴的演讲和播客里的闲谈,几乎不可能逐字交给模型生成。这些词并非 AI 写就,而是被人自己说出了口。它们直接进入了人的语言习惯。
这其实是语言习得的常识,只是我们很少把它和 AI 放在一起想。没有人是“选择”了自己的母语。一个孩子学会说话,靠的是浸泡在其中,他听到什么,就学会什么。成年人的语言也并没有停止生长,只是长得更慢,也更隐蔽。你读得最多的文字,会悄悄变成你最顺手的文字。
到这里,似乎还剩最后一条退路,也就是有意识地抵抗。既然 AI 有它偏好的词汇和句式,刻意避开不就行了?
这条路,也行不通。
2023 年,斯坦福大学 James Zou 团队在《Patterns》发表了一项研究。他们把来自中国一个教育论坛的 91 篇托福作文,交给 7 款主流 AI 检测器检测,结果,平均有六成以上被判定为 AI 生成。原因在于,非母语写作者词汇量有限、句式规整、用词偏向常见,而这些恰恰也是检测器标准中“机器文本”的统计特征。
这项研究常被用来论证 AI 检测的不靠谱,但它也揭示了,一段文字像不像人写的,标准已经由机器反向定义了。写得平实、规整、简单,会被怀疑是 AI 生成。你若想被确认为人,就得写得不像机器。而不像机器的样子,又是以机器标准为参照描画出来的。
于是写作者中出现了一种新的自我审查。2025 年前后,英文写作者开始回避破折号,因为它被认为是 ChatGPT 的标志性符号。中文世界则流传起各式各样的 AI 味检查清单,“首先……其次……最后”“值得注意的是”“不是……而是……”,一一被列入嫌疑名单。
作为一个写作者,“不是 X,而是 Z”,是我写了十几年文章最依赖的句式之一。先拆掉一个错误的认知,再立起一个新的判断,这几乎就是我理解写作的方式。它要远比 ChatGPT 早得多地出现在我的文字里。但在 2023 年之后,它成了 AI 味的标志之一。于是我面对一个荒谬的处境:继续用,就要承担被当做 AI 的风险;不用,就等于让机器决定了我不能怎么写。
无论选哪一边,我的写作都已经在被它定义。被 AI 定义,不只包括写得像它,也包括刻意写得不像它。
我时常想起俄狄浦斯,他从德尔斐神谕中得知自己将弑父娶母。为了逃避预言,他离开了科林斯,离开了他以为是亲生父母的那对夫妇。正是在逃离的路上,在一个三岔路口,他与一位陌生的老人起了争执,并杀死了他。那位老人,就是他的亲生父亲拉伊俄斯。
俄狄浦斯的悲剧不在于他没有选择,而在于他的每一次选择,包括逃离本身,都在兑现那个预言。
商品内容和个性内容
当 AI 日益渗入到我们的文化生态和意识形态中,且在可见的当下,这种趋势只会越发显性,这样的语境中,再谈抵抗 AI 写作,无疑是一种螳臂当车,结局没有悬念。你无法抵抗 AI 写作,就像无法抵抗用笔,用纸,或是用键盘写作。
同时,抵抗背后,其实暗含着一种前提,即是认定文字出自人手才是正当的,这同样是一种极为人类中心主义的论断。
而前文提到的赫希曼,在“退出”之外,还给出了另一种回应,叫 voice,中文通常译作“呼吁”,也就是不退出,留在系统之内,发出自己的声音。
在写作的语境里,voice 也可指代一个写作者自己的声音。而无法退出的人,剩下的只有 voice。既然已经承认 AI 写作是一种命运,接下来要讨论的问题就是,在一套所有人都在用、而且正在被机器持续改写的语言系统里,什么才算你自己的声音?或者更直白一些,你写下的东西里,哪些真正属于你?
美国写作教练尼古拉斯·科尔(Nicolas Cole)在一篇题为《The Right Way To Write With AI》的长文里,给出了一个我印象深刻的语言定义。他说,语言是一套用于交流的开源操作系统。
没有人拥有字母 C。没有人拥有“命运”这个词。没有人拥有“Cole”或者“王焕超”这个名字,因为世界上叫 Cole 或王焕超的人多的是。他们皆可以此自称,彼此之间并不存在任何抄袭关系。科尔为此补了一句冷笑话:这正是每个人还要被分配一个社会保障号(我们可以理解为身份证号)的原因。
顺着这条线,科尔提出了他的核心区分:商品内容(Commodity Content)与个性内容(Personality Content)。
比如,“营销的关键是了解你的客户”这句话,世界顶级营销专家可以说,社交媒体上随便一个博主也可以说。这十几个字来自公共语言,不指向任何特定的人。它的价值也极低,核心原因就是因为它没有归属,而并非是观点本身有问题。这就是典型的“商品内容”。当然大多数人自以为的“洞见”,也都是商品洞见。
在科尔看来,大语言模型正是一台极其高效的商品内容机器。当我们说 AI 味、AI 泔水的时候,其实标志特征就是没有任何归属的商品内容。它在被 AI 写出来之前,就已经被无数人写过,然后被 AI 抓取,成为人类写作特征交集的共性文字。
我想借一个国内读者再熟悉不过的经验来理解这件事:公摊。你买了一套 100 平方米的房子,实得 75 平方米,另外 25 平方米变成了电梯、楼道、管道井。你为它们付了钱,和邻居们共同持有,但你不能单独使用它。
我们写作的文章,其实有大量公摊语言。字母、词汇、语法、常识、结构讨论,全都属于公摊。真正属于你的,只有很薄的一层,供你腾挪。而这一层,就是个性内容。
你的生平事实,在哪长大、有几个兄弟姐妹、学过什么、你选择的理论,你付出代价的故事,你从故事里得到的教训。这些,才是真正有你个人印记的东西。科尔称之为“个人语言模型”(Personal Language Model)。
在方向上,我完全同意科尔的分类。但作为一条守住写作主体的防线,个性这个标准还是太软了。
科尔自己举过一个例子。一个理财顾问不说“不要加杠杆炒股”,而是说“这是我二十出头在华尔街犯过的错,后来压力大到秃了头”。加上这一句,说服力确实强了许多。
但看一眼今天的社交媒体和短视频平台,“我在 XX 岁犯过某个错,那件事教会我某个道理”这个句式,本身就成了一种可批量生产的体裁。它有标准的字数,标准的转折点,标准的自我暴露额度。个人故事一旦被验证为有效的内容格式,就会像所有有效的格式一样,被大量复制,进而进入公共领域。
换句话说,个性一旦被证明可商品化,个性就会被商品化。这是所有稀缺性的共同命运。同样,个性内容一旦被写下,它就成了语料。你越勤奋地把自己的生平、观点、故事、教训整理成可检索的文本,就越能被机器高保真地复述;而你越能被高保真地复述,“必须由你本人来写”这件事的必要性就越低。我称之为“语料化悖论”。
所以,人性化的写作防线不能只划在个性维度上。在这个基础上,我想提出的概念是,承重句。也就是,一篇文章里,那些一旦被替换,整篇文章就无法成立的句子。
绝大多数句子不是承重句。过渡句不是,铺垫不是,例证的展开不是,结构提示不是。这些更像是隔断墙,是吊顶,是涂料,交给 AI 做,不但无损,往往更好。
承重句的特征其一,它必须包含一个锋利的判断。
任何模型都被训练为让你满意,所以它的默认输出必然趋向温和、均衡、四平八稳。
判断的锋利程度,与愿意承担的后果成正比。而模型没有可被伤害的自我,它不会因为一个判断被同行质疑、被引用批评、被事实证伪。它没有需要保护的名誉,所以它也给不出需要用名誉去抵押的判断。
承受后果,要求你有一个可以被伤害的自我。
特征其二,它背后必须有一段专属的个人经验。
信息的价值在于它是新的,它在被传播的那一刻就耗尽了自己。而故事不同,故事不急于交出自己,它可以在一代人之后仍然释放意义。如本雅明认为,讲故事的人之所以拥有权威,是因为他的叙述背后,站着一段真实走过的路途,手工艺人的、水手的、农人的经验,以及最终的那个担保物,也即他的死亡。
今天再读这段,对照关系已经非常清楚。大模型是人类历史上最强大的信息生产装置,但也是唯一完全没有经验的写作者。它可能读过关于格鲁吉亚市集的一万篇文章,但它不会像我一样,在第比利斯的摊位前,犹豫要不要花几百拉里买一幅巴掌大的画,并且将这段经验作为某篇文章的开头。
这一条判据,比个性更严格。个性化句子可以被伪造,也可以被格式化,但个人经验不行,因为它带着一个只有当事人才知道的细节。
所以承重句的第二个特征是可追溯性,也就是这句话能不能追回到一段具体的、有时间地点、有代价的经历上去。
特征其三,它包含你愿意为之修正自己的位置。
我在 2024 年写过一篇《直面 AI 价值对齐挑战》,主张以发展的眼光看待对齐。两年后我写《价值对齐是个伪概念》,公开修正了这个判断。这两篇之间的裂隙,是模型无论如何都生成不出来的东西。
因为模型每一次对话都是新生的。它没有前言可以被追究,没有旧文可以被翻出来对照,因此它也不可能改变看法。它只能给出不同答案。改变看法和给出不同答案,是两件完全不同的事。
修正的前提,就是有一个连续的、需要为自己过去负责的写作主体。
从选择伦理,到分工伦理
本文开头那台书写球,其实带着科技向善的底色。它的发明者长期主持一所聋哑学院,而尼采买下它,是因为双眼已经几乎看不清纸面。对他来说,这台机器意味着,他还能假以继续写作。
AI 写作同样如此。它首先是一件伟大的工具。
我们很少意识到,写作的门槛,大部分其实砌在公摊的部分。语法、词汇、结构、起承转合,这些东西不属于任何人,但却决定了谁有资格把自己的想法写成文字。过去,为了跨过这道门槛,需要多年教育、大量阅读,往往还需要一点出身的运气。
很长一段时间里,中国的邮局门口、火车站旁,都有代写书信的摊子。来写信的,多是不识字或识字不多的人。代书先生替他们写下“父母大人膝下”“见字如面”这样的套话,这些属于公摊。但信里写的“个性内容”,今年的收成、孩子的病、在外打工的苦和念想,只能由口述的人自己说出来。
像范雨素、余秀华、胡安焉、王计兵这样的写作者之所以少见,并不是因为这样的经验少见,而是因为能把经验写成流畅文字的人少见。
而生成式 AI 第一次把这道门槛,压低到了几乎每个人都能跨过的程度。一个在工地上干了三十年的人,一个母语不是英语的研究者,一个有读写障碍的学生,一个想法很多却不熟稔写作技巧的人,可以接 AI 这个工具,把自己脑子里的东西,变成别人读得懂的文字。
这就是技术普惠。更值得玩味的是,AI 交给每个人的,恰好是它最擅长的东西;而这些人原本有的,恰好是它最缺的东西:经验和判断。AI 补足的是表达的能力,而非表达的内容。两者结合,就有可能催生出许多过去从未有机会被写下来的文字。
但这里有一个前提。普惠与趋同,原来是同一件事的两面。工地上的那个人借 AI 写出了他的三十年,这叫普惠。但如果他把写什么、怎么判断,也一并交给了 AI,那他写出来的,就只是没有价值的中位数。
AI 让更多人拥有了写作的能力,但只有不完全服从于它的人,才真正拥有自己的文字。
回到本文开头的那个问题。“用,还是不用”之所以是个错问题,是因为它预设了一个可以退往的外部。外部既然不在了,真正需要回答的,就剩一个问题,也就是在哪一层用。
这是一次伦理坐标的迁移。从选择伦理(用还是不用),转向分工伦理(我把什么交了出去,又留下了什么)。这也决定了我们的写作方式,一定会发生很大的变化。
第一,先划承重墙,再动工。
顺序很重要。现在最通行的 AI 用法,是先让模型生成全文,再由人修改润色。这个顺序很容易失守。当一篇结构完整、论述清晰的初稿摆在面前,你的判断已经被它锁定了,很难再突破它设定的框架。就像《三体》里智子锁死了人类科技,AI 那份六十分的初稿,也锁死了我们的思维结构。
正确的顺序是反过来的。先自己写出那三五句承重句,比如判断,个人经验,或是立场。再把结构、过渡、例证的扩写工作,交给模型。
第二,刻意保留一点低效。
文章风格的趋同,来自每一次局部改进的累加。比如换一个更通行的词,补一句更顺滑的过渡,把长短不齐的句子调成匀速。每一次单独看都是改进,但累加起来,就是向中位数的收敛。对抗它的方式,就是主动保留一些不改进的地方。
这不等于主动制造错误、病句,或是不通顺的表达。为了显得像人而故意写得磕磕绊绊,刻意写得不像机器,依然是被机器定义。
真正要保留的,是你本来就有的东西,一个不够顺、但只有你会这么说的句子,一段稍显冗长、但承载着你思考节奏的插入语,一个你坚持使用的生僻说法。有意保留的低效,才是可以辨认的个性签名。
第三,把精力放在第二类原创上。
在科尔的那篇文章里,他提到,原创只有两条路:说出一件从未被说过的事,或者用一种有意义的不同方式,说同一件事。
按他的说法,传统上被归于毕达哥拉斯学派的“大地是球形的”,属于第一类;约一个半世纪后,亚里士多德在《论天》中说的是同一件事,但他给出了经验证据,包括月食时投在月面上的圆形阴影,以及人在南北旅行时看到的星空变化,这就属于第二类。
这个区分在当下很重要,因为它解除了一种虚假的压力。绝大多数写作者一生都不会有第一类原创,这是常态。而第二类原创的价值,反而因为 AI 被抬高了,因为当商品内容被无限供给,用一种只有你才可能采用的方式,用你的“个性内容”,重新讲述一件旧事或是常识,就变得越来越稀缺。
苏格拉底的最后警告
在《斐德罗篇》中,塔穆斯王关于文字的警告广为流传。但讲完这个故事,苏格拉底又用自己的话补了第二个警告,更少为人所知。
他说,文字和绘画很像。画中的人物栩栩如生,可你若问它什么,它只会庄严地沉默。文字也是这样,你向它请教,它不会回应,永远只重复同一句话。文字的悲剧性在于,它一旦被写下,就四处流传,落到懂它的人手里,也会落到不懂它的人手里,它不知道该对谁说话、对谁沉默。遭到误解和攻击时,它总需要它的“父亲”来救援,因为它无力为自己辩护。
这里的“父亲”,就是作者。文字的全部脆弱,都来自于作者的不在场。
在印刷时代,作者不在场是文字的缺陷,但每一段文字背后,至少曾经站着一个真实的人。而在 AI 时代,大量流通的文本,背后可能都没有一个在场过的人。
如果说 AI 写作是一种命运,那么这种命运的最终指向,可以提炼成一句话:文本的供给变得无限,作者的在场变得稀缺。
这也是我不认为写作会死或会衰落的原因。每一次技术让某种能力变得廉价而无限,它的反面就会被重新定义、重新定价。印刷让抄写变得廉价,手抄本反而成了珍藏。摄影让画像变得廉价,绘画反而挣脱了写实的义务。生成式 AI 让文字变得廉价,能被追问、能被伤害、能改变看法、能为一句话承担后果的写作主体,反而第一次有了溢价。
1882 年,在那台书写球来到尼采身边的同一年,他完成了《快乐的科学》。在第四卷的开篇,他为新年许下的愿望是:“我要越来越多地学会,把事物中必然的东西看作美的……爱命运(amor fati):从今以后,这就是我的爱!”
你或许可以把“爱命运”理解为认命,但也可以理解成,不再把力气耗费在假装命运不存在上,而是把力气留给那些真正由自己决定的事。
AI 写作是一种命运。承认命运的存在与难违,从来是自由的开始。
本文来自微信公众号:腾讯研究院,作者:王焕超(腾讯研究院高级研究员)
本内容由作者授权发布,观点仅代表作者本人,不代表虎嗅立场。
如对本稿件有异议或投诉,请联系 tougao@huxiu.com。
如对本稿件有异议或投诉,请联系 tougao@huxiu.com。
频道: 社会文化