2026-10-29 21:59

速览
本文来自微信公众号: 未尽研究 ,作者:未尽研究
中国开源模型与美国前沿AI之间的差距,正被重新评估。在Artificial Analysis将衡量AI模型综合能力的智能指数(Intelligence Index)升级到v5版后,国产模型排名集体大幅下滑,似乎一夜之间,差距被拉开了数个身位。
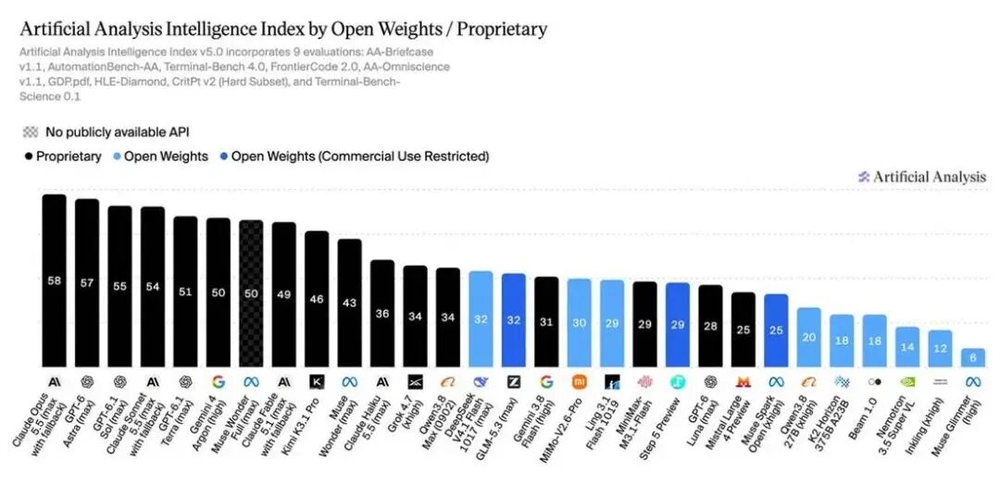
现在,排名靠前的几乎都是美国的前沿闭源模型,遥遥领先于中国开源模型。Kimi K3.1 Pro虽然进入前十,但尚未开放权重;Qwen3.8 Max排名第13,同样如此。真正已经开放权重的现役国产模型中,DeepSeek V4.1 Flash 1017与GLM 5.3分别排名第14和第15,得分均低于Anthropic入门款的Claude Haiku 5.5。
这与此前的排名大相径庭。就在几天前,Kimi K3.1 Pro还仅次于Claude Opus 5.5、Claude Sonnet 5.5和Muse Wonder Full。
不少人因此翻起了旧账,包括工业化蒸馏、过度拟合基准,以及惹眼的营销手段等,认为中国开源模型这次终于“现了原形”。OpenAI的战略未来主管迪恩·鲍尔(Dean Ball)就说,新版排名终于首次大致符合他的主观判断了。
变的是尺子。昨晚,Artificial Analysis大幅调整了衡量模型能力的方式。新版智能指数(Intelligence Index)首次有60%的权重来自私有测试集,新增真实世界编程任务评测FrontierCode 2.0,以及评估在终端环境中执行复杂长程科研工作流能力的Terminal-Bench-Science;同时升级了HLE(高难度知识与推理)、AA-Omniscience(知识可靠性与幻觉)和CritPt(研究级物理推理)三项测试。
而且,以前该指数的权重,通用能力(General)与智能体能力(Agents)各占三成,编码任务(Coding)与科学推理(Scientific Reasoning)各占两成;这次调整为各占25%,智能体进一步收敛为知识工作(Knowledge Work),而科学推理则泛化为科学(Science)。
显然,新版指数不只是继续重视AI编码能力,也大幅提高了对科研任务执行能力的考量。与此同时,从公开题集转向私有测试集,有助于降低模型针对公开基准优化、甚至记忆测试题目带来的干扰。
临近年底,这样的调整有其合理性。与单一的测评基准不同,衡量AI模型综合能力的“尺子”,蕴含着对未来哪些能力重要的判断。
行业对AI编程与智能体能力的追逐,已经持续了整整一年,见证了Anthropic对OpenAI的超越。但AI编程无法满足市场对AI提高生产率与创造经济价值的全部期待;AI编码的市场渗透,短期内似乎正在趋于饱和。
AI改变世界,不仅体现在重构软件开发,也体现在加速生物医学研究,将数十年的物理、化学等科学进步压缩到数年内。
在招股书里,Anthropic估算全球生物医药行业价值2万亿美元,相当可观。OpenAI与Anthropic都在推动AI进入真实科研流程,试图构建数据贯通、机器人自主的湿实验室反馈闭环。它们甚至抢在数学家与科学家前面发表了模型的独立发现。
在这个意义上,中国开源模型确实现出了自己的原形。今年以来,国内头部模型厂商在编码与智能体领域投入了大量精力。在今年夏天,全球软件从业者终于发现,GLM-5.2与Kimi-3同样变得“好用”起来,可以部分替代昂贵的前沿AI。但本土AI厂商有意无意地忽略了通用模型在科研领域的预训练与后训练。此前,DeepSeek可是专门研发过数学推理与定理证明模型。
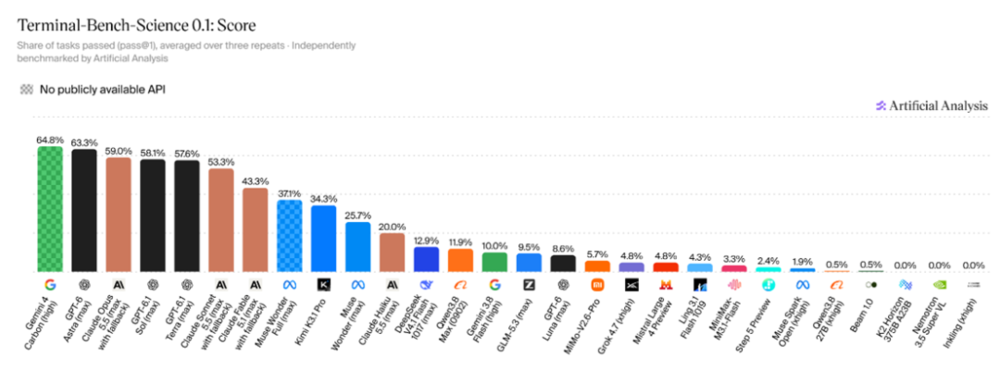
于是,在最新的Terminal-Bench-Science基准上,中国开源模型的表现与前沿AI之间,出现了断崖式的落差。
领先闭源模型能够通过约六成的任务,而大多数中国开源模型停留在10%左右的水平。这直接影响了它们在智能指数的综合表现。而谷歌今天发布的Gemini 4 Carbon,夺回前沿模型评测榜首,很大程度上也正得益于它在数学与科学等基准上的强劲表现。
这是一个苦涩的选择。长期以来,中国AI厂商在算力获取与资本投入上都受到约束,高质量数据建设也起步较晚。
在年中一份意外流出的投资者纪要中,DeepSeek创始人梁文锋谈及与海外前沿模型的差距时,就将高质量数据标注列为关键问题之一;团队有一半研究员都在参与标注数据,需要一年时间才能较好地解决问题。这还只是高质量数据的整体瓶颈,而非专门的科学研究数据。
在投入有限的情况下,资源很自然地更集中地流向了那些已经验证了技术路径、用户需求和商业化机会的方向。站在年初的节点去看,那毫无疑问就是AI编程。
但是,如果站在年末的节点上,竞争焦点正在进一步向科研工作流延伸。如果AI能够把研究假设、实验执行和结果反馈连接起来,它的作用就不再局限于帮助人类完成任务,还可能加速产生下一轮技术进步。科研闭环与AI参与自身研发的递归进化,因而可能成为贯穿2027年的重要叙事。
当然,正如长期研究开源模型的Nathan Lambert所提醒的,开源模型的衰落被过度夸大了,一把尺子难以衡量不同模型在不同应用场景下的表现。随着AI不断向各行各业渗透,需要不同权重侧重的“尺子”,去衡量不同前沿AI的能力结构。中国开源模型在AI编程领域的性价比优势,没有因为排名方法的改变以及综合排名的下降而消失。
他还质疑,私有测试集降低了外部可审计性,也将影响行业对测评机构独立性的信任。
但前沿能力上的短板,同样不能因为AI编码的商业价值依然存在而被忽略。随着AI能力逐步向整个社会汲取与给予,中国AI模型厂商及其背后的算力、数据生态,都将迎来一次不小的挑战。
本内容来源于网络 原文链接,观点仅代表作者本人,不代表虎嗅立场。
如涉及版权问题请联系 hezuo@huxiu.com,我们将及时核实并处理。
如涉及版权问题请联系 hezuo@huxiu.com,我们将及时核实并处理。