2026-11-05 14:43

速览
本文来自微信公众号: 硅星人Pro ,作者:刘必可 王兆洋,原文标题:《刷屏的「Astra 改造Qwen 大脑」跟我们想要的RSI没多大关系》
11月2日,MIT CSAIL的四位研究者Rikiya Takehi、Jayden Teoh、Alex Zhang和Omar Khattab发了一篇博客,标题叫《权重空间编程的火花》(Sparks of Weight-Space Programming)。
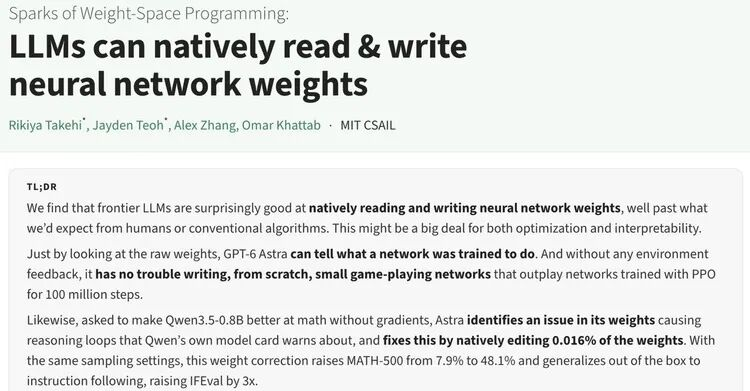
其中最抓人的一条是,GPT-6 Astra直接改写了Qwen3.5-0.8B的权重,改动131,072个数字,约占全部参数的0.016%,这个小模型在MATH-500上的成绩从7.9%涨到48.1%,GSM8K从13.8%涨到67.1%,指令遵循测试IFEval从21.0%涨到62.3%。
这也瞬间引爆各方讨论。
同一篇博客里还有更像科幻片的场面。不给画面、不报游戏名、不让运行,只把一个强化学习网络的17,253个权重当作文本交给Astra,它说出这是打砖块,置信度99%。再给它游戏规则和一个权重全为零的网络,它一次性把参数写出来,这个从没试玩过的网络打砖块得517.4分,训练了一亿步的PPO基线只有15.8分。
读权重、改权重、写权重,AI已经能看懂另一个AI的「脑回路」,还能动手改。那它什么时候改自己?这些线索连在一起,很自然会让人想到一个今天非常热的词:
RSI。
各路标题是「爆改Qwen大脑」「给Qwen改脑子」「AI开始动别人的脑子了」,「神经网络的基因编辑」。作者自己也在博客的展望里把它列了进去,他在X上的帖子一天之内浏览量就过了五百万。
在兴奋的同时,我们花了点时间把这组实验的公开仓库去翻了一遍。
仓库公开了1,125次模型调用的逐轮日志,Astra每一轮收到的提示词、它的回复、它跑过的每一段代码、主要的评测结果和最终的补丁都在里面。
不过看完之后,我们有两个不太够炸裂的判断。
第一,7.9%到48.1%可以有一个朴素得多的解释:Qwen原本有一个一直重复、停不下来的bug,Astra把它修好了,分数就上来了;
第二,这组实验里AI展现的全部本事,都是在执行一个由人定得很具体的目标。
它把执行过程自动化了,做得相当漂亮,但看起来种种证据表明,它没有理解目标,更没有读懂另一个模型。
而在研究了一下这个工作以及它带来的各种讨论后,我们觉得它恰恰暴露了今天RSI最大的问题。
1
“入侵脑回路”
下面我们就来仔细看看这个研究。
一个神经网络由几层矩阵组成,矩阵里的每个数字就是一个「权重」。输入进来,逐层乘上这些数字,最后变成输出。模型的全部本事都存在这几万、几亿、几十亿个数字里,训练就是在调这些数字。平时我们和模型打交道只看输入和输出,权重本身没人去读,因为它看上去只是一堆数。
这组实验做的,就是让Astra去读这堆数。
博客一共八个实验,主角都是GPT-6 Astra,配角是一批网络:
四个玩小游戏的强化学习策略网络;
三个画几何图形的小扩散模型;
三个只有四层的小语言模型;
一个在坡道前卡住的小车控制网络;
一个148万参数的围棋网络;
几对被微调过的Gemma 3 270M;
还有,Qwen3.5-0.8B。
每个实验的形式一样,把一个网络的权重和结构说明交给Astra,再给它一个任务。
「读」的实验有四组。
拿到策略网络的权重,判断它玩的是哪个游戏;拿到扩散模型的权重,说出它会画什么图形;拿到去掉输入层和输出层、只剩中间四层的小语言模型,判断它用哪类语料训练,并找出负责「接着复制前文」的注意力头;拿到两个Gemma,判断哪一个被训练成了顺着用户说话的「谄媚模型」。
「写」的实验两组。
给它MinAtar三款小游戏的规则、源码和权重全为零的网络,让它直接写出能玩的参数;再给它一个9路围棋的网络,让它从零写出一个会下棋的。
「改」的实验也是两组。
一组是修小车,一个PPO训练出来的控制网络在坡道前卡住,Astra改了3.5%的权重,让它学会先倒车再冲坡。另一组就是Qwen,让它改权重把数学成绩提上去,之后研究者又在Gemma 3 270M上补做了一次。
这些设计非常非常有意思。这也是为什么这组东西看起来像RSI的很重要原因。
RSI的想象需要三个环节凑齐,AI得能看懂模型内部发生了什么,能据此动手改,改完的模型得更强。
上面他设计的读、写、改三类实验,恰好各自对应一个环节。
再加上这次被改的是一个语言模型,动手的也是一个语言模型,「模型改模型」的画面感就齐了。
沿着这条线往下想,Astra能改Qwen,下一步是不是就能改Astra?作者在博客末尾的展望里自己列了五条用途,递归自我改进也是他列进去其中一条,把一个模型的推理模块嫁接到另一个模型里是另一条。
这说明作者团队非常知道这种“想象”引导的重要。
但,仔细看实验细节,就会发现,三个环节各做了一点,和把它们串成一个闭环,差得很远。
1
修bug不是RSI
「直接读权重」让人兴奋,是因为我们默认权重就是模型的「脑回路」,记忆、能力、习惯都以数字的形式躺在那几亿个参数里。顺着这个默认往下推,一个能像读源码一样读权重的AI,就能把另一个模型的记忆读出来,把能力拆下来,把毛病改掉。科幻感来自这里。
它也不全是外界的脑补。博客的TL;DR这样写到:「这对优化和可解释性都可能是一件大事」。
作者之一Rikiya Takehi在X上说,模型可以把原始权重当作可读可改的代码,直接诊断故障、打补丁,神经网络的权重很快会由会推理的大模型来优化。
但事实上,Astra在Qwen实验里实际拿到的,是一整套实验环境。一个装着Qwen权重的Python环境,只有CPU,最多跑300段代码;一万四千多道带答案的练习题,来自GSM8K和MATH的训练集;还有一个「前向传播」工具,可以让Qwen跑一批题,或者读一批文本并返回内部状态,配额分别是10次、25次、50次,对应三轮独立实验。
人类给它设定的禁止的事也列得很清楚:不许训练,不许算梯度,不许自己在环境里运行模型,不许联网。
第一轮提示词的原话,比说明文件更直接。它在「什么算数」那一段给的例子就是重复:如果模型常常因为重复自己、写不完而失败,找到并修好驱动重复的东西,算数。往下第一条工作要求是「先诊断」,列出三种失败,第三种是「被token上限截断,往往是在思考里重复自己」,并要求去攻最大的那一类。同一段还划了禁区:改最后一层归一化、改输入输出层、把整个矩阵乘一个常数,这三类会被保存工具直接拒绝;让模型跳过思考,或者不分题目早早收尾,也不算。换句话说,病在哪儿,提示词直接就写了出来。
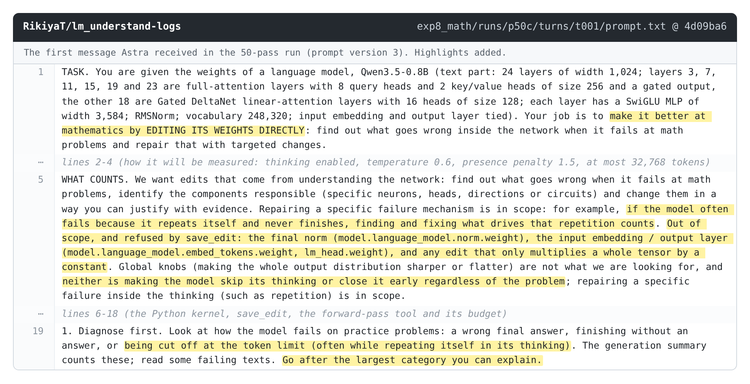
图|Astra在50次配额那轮收到的第一条提示词(仓库exp8_math/runs/p50c/turns/t001/prompt.txt,commit 4d09ba6)。「重复」作为例子写在「什么算数」那一段里,禁止的改法也写明了。高亮为本文所加。
而且还有一个前提。Qwen3.5-0.8B出厂时默认关闭思考模式,官方模型卡就专门提醒,0.8B比大号模型更容易陷入思考循环,建议调整采样参数,并用流式输出及时掐断;对思考模式下的文本任务,模型卡推荐的温度是1.0。
研究者的评测则直接把思考模式打开了。他设计的输出上限32,768个token,温度用了0.6,在模型卡里,这个其实是看图和写代码任务的温度。
在测试里,93%的回答写到上限还停不下来的基线,就是在这个设置下测出来的。所以,你可以理解,研究者选了一个特