2026-10-15 17:09
速览
本文来自微信公众号: 蓝字计划 ,作者:黄晓彬
曾经的大模型三巨头,如今看着更像两个巨无霸,带着一个小老弟。
这个“小老弟”,说的就是谷歌。
OpenAI和Anthropic在今年都不知道已经发了多少代新旗舰模型了,谷歌却在七个多月里都没有推出Flash以上级别的新模型。Flash再能打,终究也替不了旗舰的位置。
一个手握顶级人才、算力和自研芯片的巨头,总不能真就这么掉队了吧?
现在,这个等了许久的旗舰终于来了:Gemini 4 Argon。
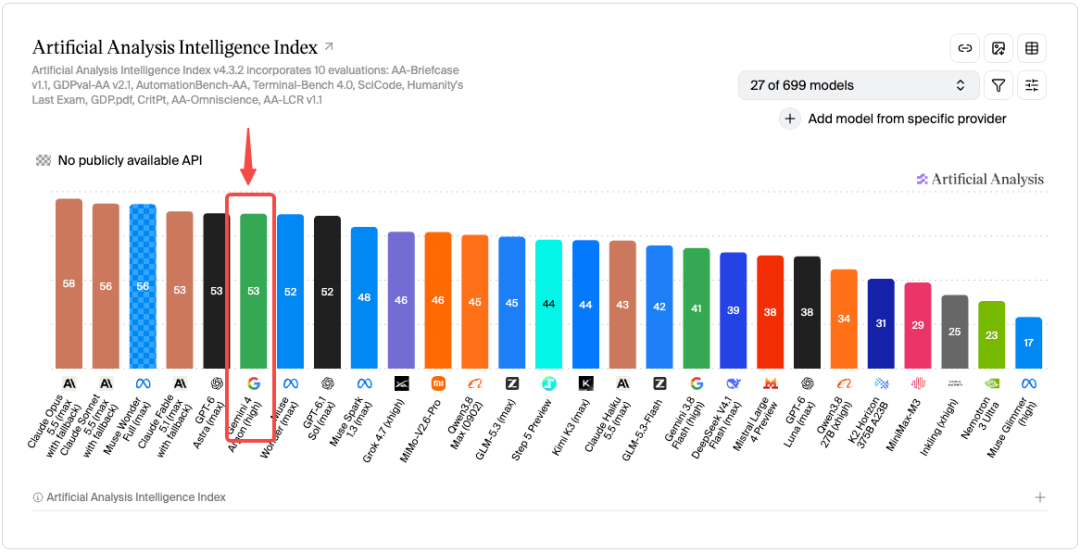
在第三方评测机构Artificial Analysis的综合智能指数中,Argon拿到53分,追平GPT-6 Astra(低于Claude Opus 5.5的58分),谷歌总算重新挤进了第一梯队。
按理说,憋了这么久,谷歌该把最硬的成绩拍到桌上,让大家看看谁才是老大。但Argon这次最抢眼的卖点,却是便宜。
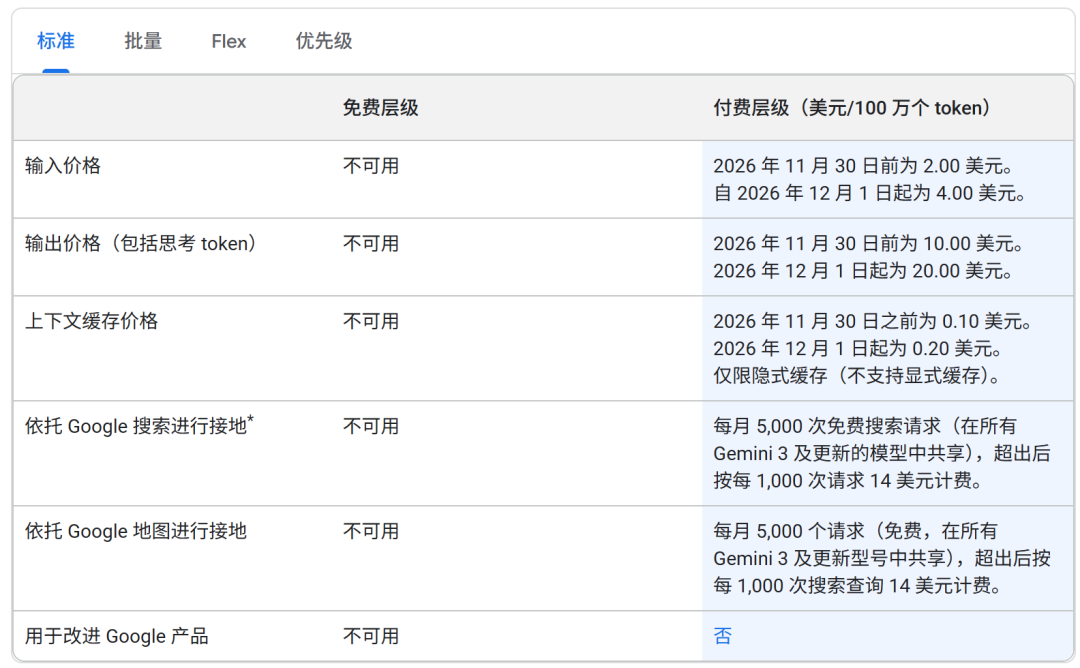
首发期间,每百万输入token 2美元,输出10美元。输入单价只有GPT-6 Astra的五分之一,Claude Opus 5.5的一半。
这就有意思了。过去,低价高效是Flash这类轻量模型最常打的牌,旗舰负责的则是把模型能力的天花板撑爆。
如今谷歌等了这么久才端出新旗舰,怎么也先吆喝起性价比来了?
专啃硬骨头的“理科重劳力”
仔细看Gemini 4 Argon的能力分布就会发现,谷歌这次最拿得出手的成绩,主要落在软件工程、金融法律文书、企业自动化和前沿科研这些多步骤的苦力活上。
为了干这些重活,这一代最重磅的升级,是通过Long Decode Continuation跨请求续写机制,将思考与输出预算从此前的6.4万token扩展到了最高约100万token。
不过这里得先泼盆冷水:这100万token是个“共用大池子”。你喂进去的资料、模型自己在后台琢磨的草稿,再加上最后吐出来的答案,三者加起来一共只有约100万的额度。
也就是说,你塞给它的参考资料越多,留给它思考和写答案的空间就越少。而且常规单次请求的额度仍在约3.3万至6.5万token,真想让它敞开写,得把长解码配起来。
话虽如此,这个升级对企业来说依然很振奋人心的。
以往面对完整代码库重构、数百页财报研判或者复杂的企业内部工作流,输出额度不够、任务频繁中断,是开发者会碰到的麻烦。现在有了跨请求续写和更大的处理空间,模型就能更连贯地把长链路任务跑完了。
在谷歌公开的19行基准评测结果里,Argon有13行成绩领先对比模型,另有1行并列第一,偏向真实业务的硬核测试尤其亮眼。
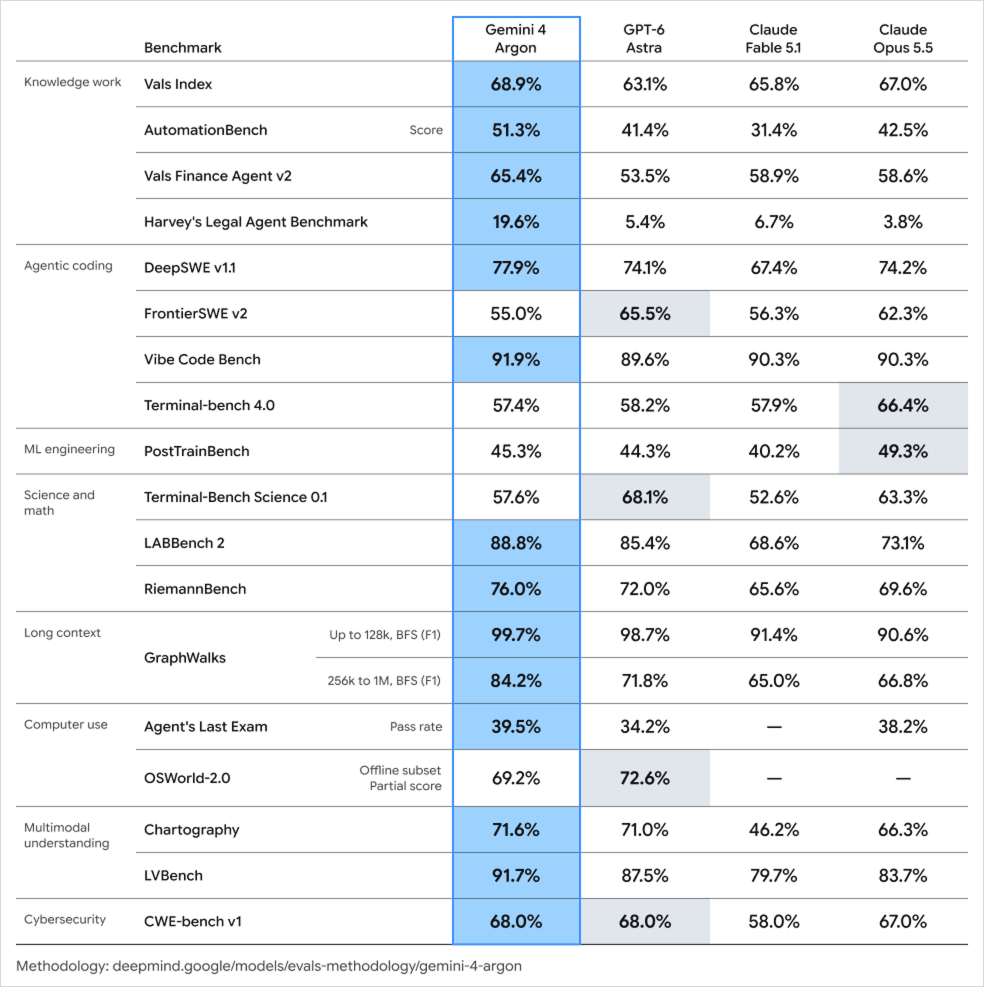
比如在覆盖金融、代码、法律、税务的Vals Index评测中,它以68.9%拿下了当时41个参评模型里的第一;法律细分领域的Harvey基准大幅甩开对手;Zapier企业自动化测试(AutomationBench)拿到51.3%,领先最接近的对比模型约9个百分点。
到了软件工程和科研领域,谷歌放出的几个案例,更能看出它啃硬骨头的底子:
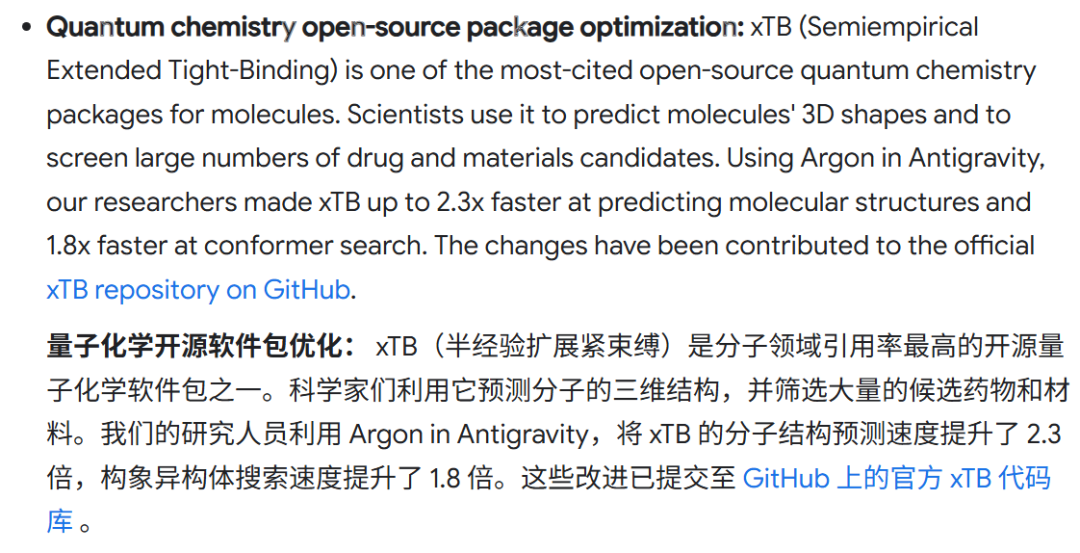
在真实代码仓库修复基准DeepSWE v1.1中,Argon拿到了破纪录的77.9%。落到实战里,研究人员用它参与优化开源量子化学工具xTB,把分子结构预测速度最高提升至原来的2.3倍,相关代码已经提交至GitHub官方仓库。
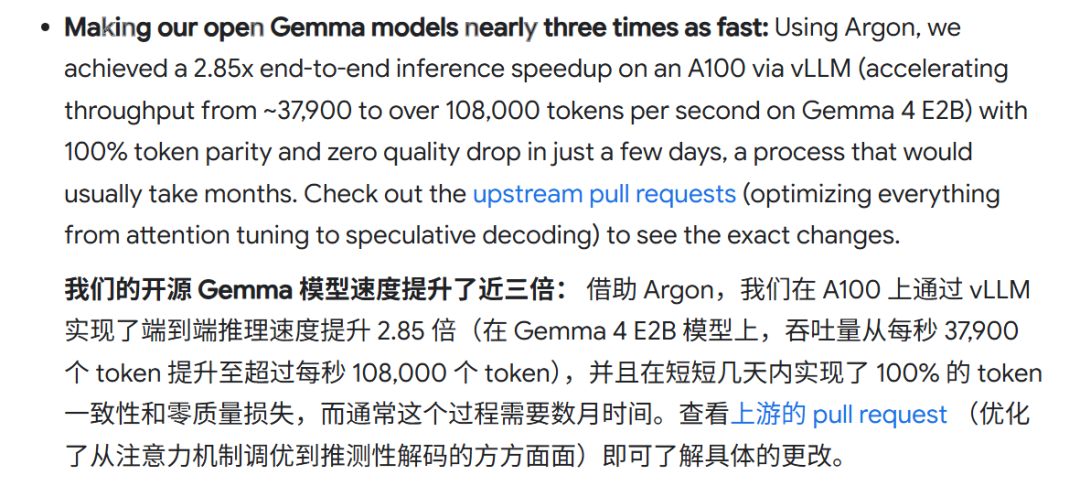
另一个很能说明问题的实验是“底层调优”:研究人员借助Argon,短短几天就完成了自家开源模型Gemma 4 E2B推理链路的深度改造,在A100显卡和vLLM环境下,生成质量分毫不差,端到端推理吞吐直接达到原来的2.85倍。
按谷歌的说法,以前这种抠细节的底层苦差事,工程师团队通常得熬好几个月时间才能干完。
而在生物与物理科研中,它帮研究人员设计并筛选出5种全新酶的候选方案,后续进实验室验证,五种方案居然全都测出了催化活性;在核聚变仿真研究里,它还参与寻找磁场数学模型的新解,为检验仿真程序提供测试基准。
虽说科研成果仍要经过严谨验证,但作为帮研究人员筛方案、找思路的工具,它已经展示出了压缩试错周期的潜力。
另一方面,Argon还有一个很讨B端客户喜欢的特质:知之为知之,不知为不知。
在AA-Omniscience测试中,Argon的答题正确率为50%,其实低于GPT-6 Astra Max的63%。
但有意思的是,在那些没答对的回答里,Argon的错误作答占比只有15%,其余包括部分回答和没有尝试作答;反观GPT-6 Astra Max,这个比例达到51%,也就是说在一些它不知道的问题上,它还是选择嘴硬硬猜。
对于法务、金融、科研这类容错率极低的行业来说,宁可模型摊手说不知道,也绝不能让它一本正经地瞎编数据。
所以,如果只看上面这些长链路任务和官方演示,Gemini 4 Argon简直是个任劳任怨的模范员工。
但只要把视角切换到另一半榜单和开发者的真实反馈里,就会发现这名“理科重劳力”偏科偏得相当严重。
一做精细活就露怯
在10月14日更新的Agent Arena总榜上,Argon排在第四,略高于GPT-6 Astra。
不过,到了考验软件工程能力的FrontierSWE v2、网页开发Code Arena,以及考验终端实操的Terminal-Bench 4.0,它就没那么风光了,复杂前端交互和3D细节生成也在部分开发者的测试里暴露出了短板。
纸面跑分和真实体感之间的温差,也很快引发了争议。
有媒体援引匿名消息称,部分谷歌员工认为模型在内部测试中的表现不够理想,谷歌否认了相关报道的准确性;一些外部开发者上手后也吐槽,这模型对提示词非常娇气,默认输出质量只能算平庸,得靠额外的指令技巧去慢慢磨合。
而且在网络安全等敏感任务上,公开版本还保留着安全护栏,会拒绝高危请求,移除网络安全护栏的特殊版目前只向定向合作伙伴开放。
最让谷歌尴尬的,是一位开发者在社交平台上晒出的同题对比实测:
他用相同的提示词,让Claude Opus 5.5和Gemini 4 Argon写代码,做一个“能被拉扯爪子、压扁、扔出去的橡皮熊”交互式物理模拟。
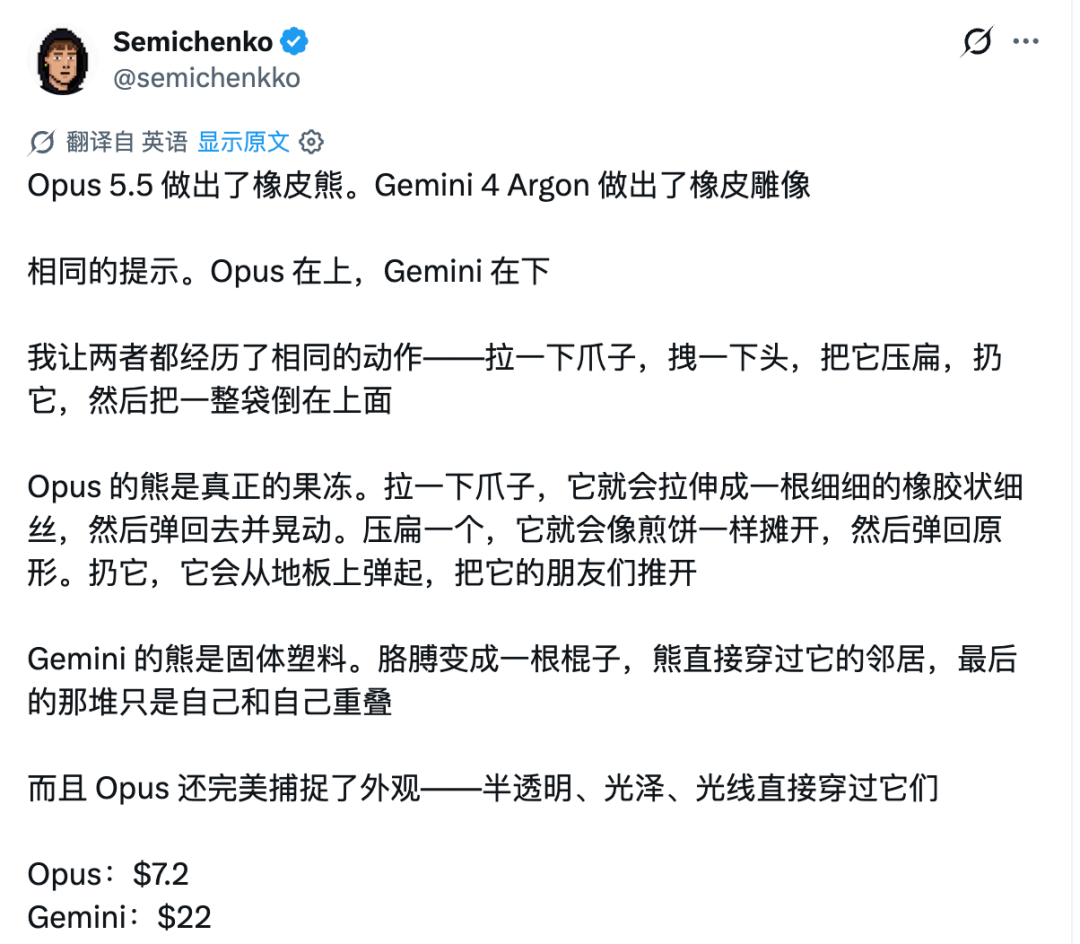
结果高下立判。Opus 5.5交出来的确实是颗半透明、带光泽的果冻熊,拉一下爪子会拉伸成细丝再弹回去晃动,压扁了像煎饼一样摊开又能回弹。
而Argon做出来的完全是一块硬邦邦的固体塑料,胳膊一拉直接变成一根死板的棍子,扔在地上连物理碰撞都失效了,一堆熊直接穿模叠在一起。
更扎心的是这位开发者在结尾标出的花费:做出完美果冻熊的Opus 5.5只花了7.2美元,而搓出塑料废品的Gemini 4 Argon,居然烧掉了22美元。
这就把所有人看懵了:不是刚吹完输入单价只有Opus的一半吗?怎么活儿没干好,钱反而是对方的三倍左右?
看似便宜,实则更贵了
“22美元塑料熊”的翻车现场,恰好撕开了谷歌这次定价策略里的尴尬之处:单价便宜,但不等于总账单便宜。
先把谷歌这套设计精巧的API价格表摆出来看看:
在2026年11月30日之前的首发优惠期,Argon输入2美元/百万token,输出10美元/百万token;同时给了一个高达95%的缓存输入折扣,折后低至0.1美元/百万token。到了12月1日,则会恢复到两倍于优惠价的标准价(输入4美元、输出20美元、缓存0.2美元)。
按优惠价和实际token用量测算,Artificial Analysis给出的综合智能评测平均任务成本为1.99美元,确实比GPT-6 Astra便宜约39%,比Claude Opus 5.5便宜约67%。
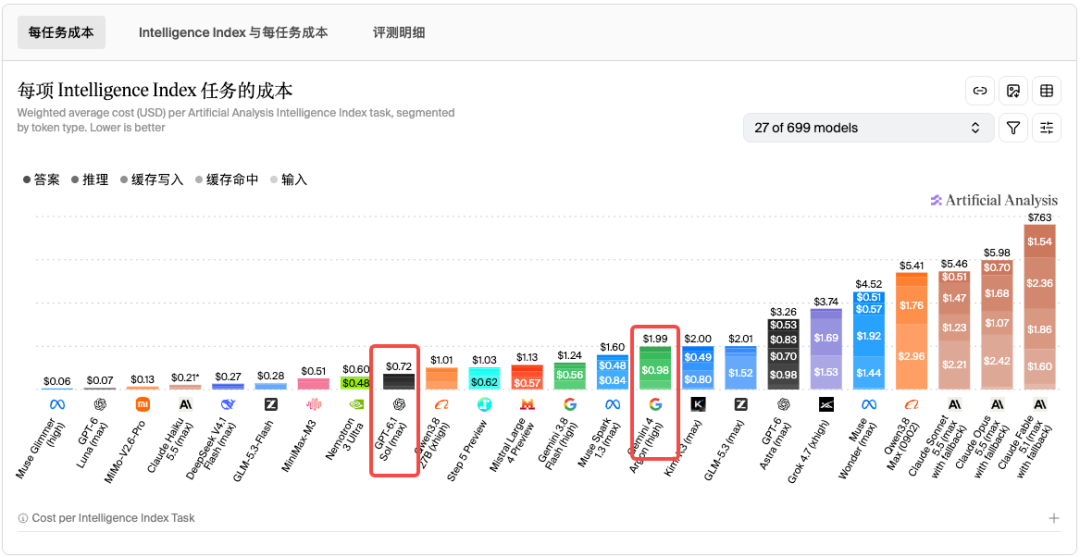
尤其是那个0.1美元的缓存骨折价,如果你的业务像代码Agent或企业文档审查那样,每天成百上千次地反复读取同一座代码库、同一批旧合同,一旦命中缓存,那价格的确便宜得没朋友。
但问题在于,这模型在高推理设置下的输出token消耗实在太大了。
第三方评测数据显示,在这套综合智能测试里,Argon High平均每项任务要吐出约6.2万token,消耗量大约是GPT-6 Astra Max的2.3倍。而且输出,包括思考token的价格,达到了每百万10美元,本来就是普通输入价格的五倍。
这说明,很多时候Argon只是看起来便宜。模型在后台多想、多写,照样会增加费用;如果效果不好,还得反复重试,最终的结果就是根本省不了几个钱。
等到12月1日限时优惠结束,那Argon的价格还得起飞。按标准价重算,AA同一套测试里的平均任务成本会从1.99美元涨到3.98美元,反过来超过Astra的3.26美元。
既然眼下的优惠只剩一个半月左右,高推理设置下又这么费token,谷歌为什么还要大张旗鼓地搞这场“限时半价”?
只能说,谷歌想卖的,显然不只是API调用量。
趁着11月底前的半价和0.1美元缓存红利,先把开发者哄进门,争取让企业把代码库、内部文档的处理任务和自动化工作流接入Gemini,再顺手跟自家的云服务、Workspace、安卓和搜索业务串成一条线。
考虑到企业级业务最看重的就是稳定,一旦公司的整套自动化流程都围绕谷歌的模型和工具搭好了,迁移成本就可能高得吓人。到那时,就算12月准时涨回原价,甚至别家模型在某些榜单上又反超了几分,已经进了谷歌坑的企业们,估计也不会愿意重新脱坑了。
其实,如果不从这个角度来解释,真的很难想象当年恐怖如斯的谷歌,怎么会憋了七个月之后,只交出了Argon这样的旗舰模型;而且在性能不突出的情况下,只维持了一个半月的便宜价格。
但企业级用户们一个个都是人精。如果Argon的实力就只能交出一个“22美元的塑料熊”级别,那就真的只能祝谷歌好运了。
参考资料:
硅基深蓝:《跑分打平GPT-6,谷歌Gemini 4发布,限时半价》
新智元:《谷歌物理真觉醒!全新Gemini 4 Argon一大波实测来了》
爱范儿:《Gemini 4发布:限时半价!性价比「斩杀」GPT-6和Opus 5.5》
数字生命卡兹克:《实测Gemini 4 Argon-Google这跌跌撞撞的背水一战。》
本内容来源于网络 原文链接,观点仅代表作者本人,不代表虎嗅立场。
如涉及版权问题请联系 hezuo@huxiu.com,我们将及时核实并处理。
如涉及版权问题请联系 hezuo@huxiu.com,我们将及时核实并处理。