2026-11-19 12:35

速览
本文来自微信公众号: 鲜枣课堂 ,作者:小枣君
前几天,美国全境航班停飞的事,闹得比较大。
一次例行的通信线路升级,直接导致全美航班停了4个多小时,上万架次航班取消或延误,大批旅客滞留在机场,影响确实非常恶劣。
作为一个通信老司机,小枣君觉得,虽然这次事件已经结束了,但事件的背后,还是有很多值得复盘的地方。
除了看热闹,我们也需要认真思考,事件给整个通信行业带来哪些教训和启示。
█事件回顾
我们先简要回顾一下事件经过。
美国当地时间11月13日15点36分,全美各区域管制中心和终端雷达进近管制设施的雷达、通信数据开始出现不稳定。
15点53分,也就是17分钟后,FAA(美国联邦航空管理局)空中交通管制系统指挥中心发布通告,以“特殊情况与安全原因”为由,下令全国机场地面停飞。所有尚未起飞的国内航班原地停留,起飞时间另行通知。
20点15分,FAA宣布解除停飞,空域重新开放。
这次全美大停飞,前后持续约4小时23分钟,是自“9·11”事件以来美国最长的一次全国性航班停飞。
█事件影响
这次全美停飞的影响,看几组数据就清楚了:
13日当天,航班追踪平台FlightAware的数据显示,美国约9200架次航班取消、7500架次延误。
到了14日18点45分,各航司又取消超过6150架次、延误7300余架次。此外,还有超过530架原定15日飞行的航班,被提前取消。
两天加起来,取消的航班超过1.5万架次,延误的超过1.4万架次。
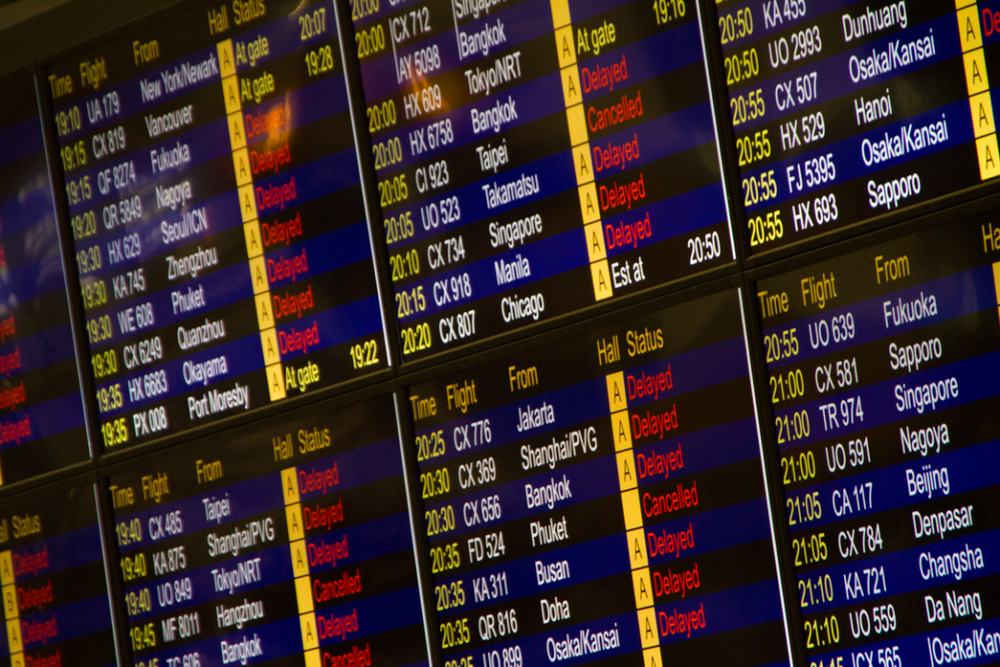
大批航班延误或取消
影响还波及美国之外。13日晚,欧洲空管组织(Eurocontrol)应FAA要求发布通告,一度暂停其成员国出发飞往美国机场的所有航班。加拿大航空也一度暂停了美加之间的往返航班。
停飞令解除,不等于一切恢复原状。飞机、机组、旅客的节奏都被打乱了,整个美国航空运输业一地鸡毛。到了16日,才基本恢复正常。
这次停飞,不仅给广大乘客带来了极大的不便,也造成了巨大的经济损失。
据美国航空协会估算,仅13日当天,美国各大航空公司的直接经济损失就超过2.5亿美元,这还不包括后续航班取消、旅客改签、退票、住宿补偿等间接损失。若将两天的累计影响算进去,总损失规模可能超过5亿美元。
█故障原因
那么,这次故障到底是怎么发生的?
出事的这套系统,是FAA的空管电信基础设施网络FTI(FAA Telecommunications Infrastructure)。
这是一张承载区调互联、雷达数据、空管专线语音的专网。管制中心之间、管制员与飞机之间的无线电通信、雷达数据、飞机位置信息,都跑在这张网上。它是美国空管体系的底层基座,重要性不言而喻。
FTI并不是FAA自己运营的,而是外包给了一家私人承包商——L3Harris Technologies公司。
这家公司2019年由L3 Technologies与Harris Corporation两家老牌军工巨头合并组建,业务覆盖专网通信、雷达、航电、电子战、卫星与导弹系统等。
事发当天,L3Harris进行了一次常规维护作业,把一处偏远站点空管系统的老旧铜缆升级为光纤,同时更换相应的路由器。
升级过程中,一台(有说法认为不只一台)新安装的路由器出现异常,开始向其他路由器发送大量连接请求,每4到5秒就超过1000次。
搞网络的读者应该不会陌生,这其实就是一场非主动意愿的DDoS攻击。大量异常请求造成通信网络过载,FAA下属22个区域空中交通管制中心,其中17个受到影响。
故障究竟是施工人员安装配置失误,还是路由器本身存在缺陷,目前仍在调查之中。
网络拥塞,不同管制中心拿到的飞机位置数据对不上,管制员无法判断空域是否安全。这种情况下,只能暂停新航班起飞。
此外,航行通告(NOTAM)、广播式自动相关监视(ADS-B)等系统,也都依托FTI网络。NOTAM告诉飞行员跑道关闭、导航设备故障等信息;ADS-B让飞机主动广播自己的位置。FTI网络一旦无法正常运作,整套安全链条都会受影响。
故障刚发生的时候,官方首先怀疑是网络攻击和恐怖袭击。但很快,调查人员排除了外部入侵的可能,确定就是FTI自身的问题。再后来,技术人员找到了故障源头。进行隔离处理后,网络逐步恢复。
█近年故障不断
这次停飞事件,并不是美国航空系统首次出现问题。事实上,最近这些年,他们已经多次出现和信息通信技术有关的故障:
2023年1月,FAA因航行通告(NOTAM)系统故障,命令所有国内航班停止起飞约两小时,导致1300多架次取消、近1万架次延误。事后调查发现,是承包商工作人员在修正主备数据库同步时,误删了部分文件。
2025年4月和5月,纽瓦克机场两度因老旧通信线路故障出现中断,管制员一度约90秒拿不到雷达信息。
2026年9月,费城一处空管设施的通信线路发生故障,系统切换到备用光纤时,发现备用线路已经被施工人员意外挖断,约7000架次航班延误或取消。
再往前,2009年11月19日,FTI网络也断过一次:一处长期休眠的配置错误,被洛杉矶路由器的重启触发,约75%的网络流量被堵死,恢复用了将近5小时。那次并没有发布全国停飞令,但影响同样恶劣。
█本次事件暴露出的问题
以上是整个全美停飞事件的来龙去脉。接下来,我们看看,事件暴露出哪些问题。
首先,事件发生后,带给我们最大的感受,就是美国的公共基础设施确实是非常脆弱。
FTI作为一套覆盖全美空域的国家级关键基础设施,整体技术水平还停留在上世纪90年代。
美国政府问责局(GAO)2024年的报告显示,FAA管理的138套空管系统中,51套被认定为不可持续运行,另有54套可能存在类似风险,两者合计105套,约占76%。
这105套系统里,73套用了超过20年,40套超过30年,6套甚至超过60年。61套难以取得备件,62套缺少相关维修专业人员。其中,部分系统的通信线路,仍在使用上世纪60年代铺设的铜缆。
FAA局长贝德福德在发布会上说,光是维持这套上世纪的网络,一年就要花约10亿美元。路透社还提到,一些过时设备,只能去网络拍卖平台淘零件。400多处空管设施的老旧软盘,要到2028年底才能淘汰完。
软盘这种东西,国内的年轻人基本上都没见过。之前有新闻指出,美国的核武系统,还有波音一些客机的驾驶舱,也还在使用软盘。
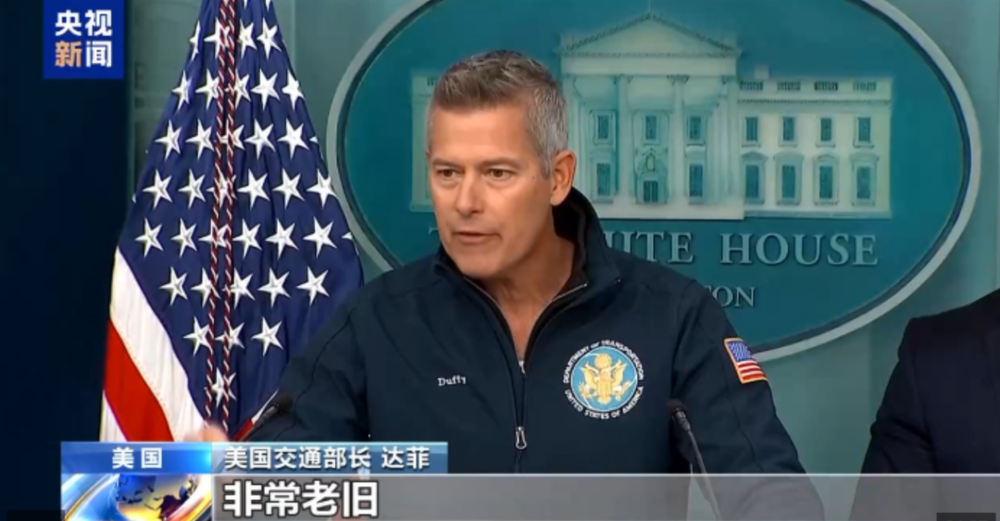
在新闻发布会上,美国交通部长达菲自己也承认,空管系统仍依赖模拟通信技术(TDM,时分复用),交换机、路由器因数据负荷过大而过载,输出不一致的数据。模拟技术打底的通信底座,根本扛不住高负载,这也是关闭系统的主要原因。
美国人也知道自己的系统老旧落后,也希望进行升级换代。美国也并不是没有钱来干这事。
但美国的公共基础设施升级,却往往卡在政治博弈、预算审批、部门协调和既得利益上,迟迟难以推进。
2025年,拜登政府曾提出一项为期五年、总额约400亿美元的空管系统现代化计划,但该计划在国会审议中遭遇阻力,部分议员质疑资金规模与实际成效的匹配度,导致计划至今仍停留在讨论阶段。
早在2018年,FAA就启动过“下一代空管系统(NextGen)”的升级项目,原计划2025年完成核心架构替换,但受制于预算拨付节奏、承包商交付延迟以及新旧系统切换风险,项目进度一再推迟。
这次停飞事件的主因,铜线换光纤,FAA其实已经提了几十年。2025年,FAA突然将原计划到2038年的20年工程压缩到2.5到3年,投入125亿美元加速推进。结果,进度刚过一半,就出了这次事故。
有意思的是,停飞前一天,达菲致信国会申请的是301亿美元。停飞之后,这个数字变成了500亿。出了事,首先想到的是狮子大开口要钱,也是没谁了。
其次,这次事故除了设备本身之外,也肯定有人为的因素。
从事通信行业的读者都知道,现网通信系统的升级改造,无论是公网还是专网,都有一套严格的操作规程,包括夜间低峰期割接、业务倒换验证、回退预案演练等环节。
故障发生在下午15:36,正值航班高峰时段。为什么会在这个时间点?难道路由器和光纤是白天替换的吗?为什么不安排在晚上?
升级替换方案是否存在缺陷?替换之后,有没有做业务验证和测试?有没有checklist?为什么没有在第一时间发现问题并回退?
事故持续了4个多小时,排查过程为什么需要这么长的时间?个别路由器出现异常,应该并不难排查。
局部网络出现问题,为什么没有隔离住?而是让故障扩散到了整个系统?是不是路由策略和隔离机制存在设计缺陷?
这些疑问,指向的或许不只是技术层面的疏漏,也不是单纯的运气不佳,更是流程执行与应急管理上的松懈。
相关工作人员的专业技能水平,也值得提出质疑。是不是执行操作的工程师技术存在不足?还是说,在工期被大幅压缩的压力下,原本应该严格执行的流程被简化甚至跳过了?
以上问题的答案,我们可能都需要等最终调查报告公布之后,才能完全知晓。
这次事故,也暴露出美国公共基础设施运营模式方面的问题。
FTI的运营权被FAA整体外包给单一私营承包商,这种模式虽然降低了政府的直接运营成本,却也把鸡蛋放进了同一个篮子里。一旦承包商在某个环节出现疏漏,整个系统就会面临连锁反应式的瘫痪。
这种外包模式在美国电网、水务、通信、交通信号等关键领域普遍采用,其实都存在类似的隐患。
当公共安全的核心命脉掌握在少数几家商业公司手中,其运营的透明度、维护的及时性以及面对突发事件的响应能力,就不可避免地要打上问号。
总而言之,如果美国在公共基础设施建设和维护方面继续保持现在这样的尿性,那么,类似的事故恐怕还会再次发生。
美国作为超级大国,其基础设施曾经是世界的标杆。
但是,随着时间的推移,曾经的标杆正在逐渐褪色。从桥梁坍塌到电网瘫痪,从铁路事故到航空通信中断,一系列事件反复刺痛美国民众的神经。如果他们不从根本上反思并调整基础设施的运维与监管体系,那么,他们还将付出更加沉重的代价。
民众对公共部门的信任,会逐渐崩塌。美国政府的信誉,也将遭受不可逆的损伤。
█我们能从这次事件学到什么
停飞事件发生后,国内媒体也进行了详细的报道。国内的情绪,普遍是吃瓜看热闹,甚至带着几分幸灾乐祸。
其实,冷嘲热讽并没有什么实际意义。相比之下,冷静地从中汲取教训,避免类似的问题发生在自己身上,才是我们真正应该做的。
虽然我们国家的公共基础设施现在整体水平处于世界前列,但并不意味着可以高枕无忧。
最近这些年,我们国家在新基建领域取得了举世瞩目的成就,但是,快速的建设和升级,往往可能引入新的技术风险和运维挑战。
说实话,虽然我们嘲笑美国人还在用几十年前的技术,还在用铜缆,还在用模拟技术,但我们的一些专网,其实也有老旧设备。例如SDH光传输设备和程控交换机,仍在部分关键节点服役。
专网的要求从来不是技术先进,而是稳定可靠。这些设备虽然技术代际较老,但工作正常,运维成熟,因此相关单位替换意愿不强。
然而,随着设备进入生命周期的末期,备件停产、原厂放弃支持、维护人员断层等问题,正在逐步显现,也可能带来安全隐患。对这些设备进行替换升级,也存在风险和挑战。
大家都知道,信息通信设备都有这么个特点——一旦运行,尽量不要去碰,一碰,就可能出问题。
升级改造过程,是最容易出问题的。新老系统并存的阶段,风险往往最高。
没有什么系统是绝对安全可靠的。问题总是会以莫名其妙的方式出现,也可能会以莫名其妙的方式被解决。
这些年,很多设备厂商都在吹嘘运维技术有多么多么先进,系统有多么多么安全。但真正到了关键时刻,还是会出现各种状况。要么是设备出问题,要么是人出问题。
小枣君还是觉得,一定要对技术有敬畏之心,对系统有敬畏之心,对风险有敬畏之心。不要因为技术先进就盲目自信,也不要因为系统稳定就掉以轻心。
我们新上线的系统太多,而且这些系统的重要性越来越高,一旦出现故障,影响范围往往远超预期。最近这些年,其实我们也经历过不少类似事故。只不过,并没有美国这么严重。
最后,我想提一下AI。
现在AI正在高速发展,各行各业都在搞智能化。我们ICT行业也不例外。用AI加强网络管理、监控和自动化处理,用AI进行故障预防和处理,是一个重要的趋势。
AI其实是一把双刃剑。
它的好处,是效率确实更高——告警、日志、性能数据,人看不过来,它能看;重复的运维动作,它能替人干;故障定位,它比人快。借助AI,确实可以大幅提升系统安全性和可靠性,能够有效降低人为失误带来的风险,也能在故障发生前提前预警,把问题消灭在萌芽状态。
但AI并不是绝对安全的。AI用得越多,越容易给人一种错觉:系统好像更安全了。实际上,它同时把复杂度往上抬了一格。模型会幻觉,自动化会误操作,黑箱决策出了问题,还不好追溯。
这次美国停飞事故里,FAA刚上线的AI调度系统一度被怀疑,虽然最后排除了,但这也说明,新技术一进场,大家第一反应就是“会不会是它”。
AI可以当副驾,但不能让它闭眼开车。随着AI用得越来越深,它本身就应该被列进风险清单:每一个动作,是否可监控、可审计、可回滚?AI出了错,人能不能兜得住底?
这些都需要我们充分考虑,也有必要建立相应的机制和预案,不能把命脉完全交给机器。
█结语
好了,以上就是小枣君对这次全美停飞事件的一点看法。
把别人的教训,变成自己的经验,才是正确的做法。对设备保持敬畏,对变更保持谨慎,对新技术保持清醒,才是我们真正应该时刻提醒自己的。
面向未来,人类的命运越来越依赖于ICT系统的稳定和可靠。小枣君个人认为,故障永远都不会停止或消失,故障的影响和危害只会越来越大。我们能祈祷的,就是末日级的系统灾难,永远不要降临在人类头上。
本内容来源于网络 原文链接,观点仅代表作者本人,不代表虎嗅立场。
如涉及版权问题请联系 hezuo@huxiu.com,我们将及时核实并处理。
如涉及版权问题请联系 hezuo@huxiu.com,我们将及时核实并处理。
频道: 车与出行